第2章 R 数据读取、清理、Table 1 与固定划分
现行主案例执行入口(2026-09-19)
Myocardial_Infarction_Complications的唯一执行根位于仓库 04_Cases/Myocardial_Infarction_Complications/,参数由analysis_config.R维护。按案例运行指南执行,不能复制本章技术Demo的变量、折数或数值替代主案例。
| 任务 | 主案例脚本 |
|---|---|
| 读取与描述、固定成员 | L01_Read_Check_Demo.R、L02_Data_Preparation.R |
| LASSO lambda.min按原始变量筛选、普通Logistic | L03_Feature_Selection_Logistic.R |
| 完整训练内筛选/调参的外层OOF | L04_Internal_Validation.R |
| 共享特征的RF/XGBoost/SVM与SHAP | L05_ML_Comparison_SHAP.R |
| 第5课集中纠错、Kappa冻结与留出对照 | L06_Data_Audit_T0_Correction.R |
| 单变量整体LRT与AIC机制展示 | Teacher_Selection_Demonstrations.R |
| 冻结系数列线图及验证 | Export_Classroom_Artifacts.R、Validate_Review_Run.R、Check_Separation.py |
| Python完整统计主链快速展示 | Export_Python_Raw.R、Python_Statistical_Workflow.py |
Python演示保留原始缺失与固定成员,在各训练范围独立筛查、插补和选择lambda.min,再按原始变量拟合普通Logistic,训练OOF最大Kappa阈值冻结后用于测试。使用scikit-learn 1.9的SAGA,与R glmnet内层实现不同,不要求数值完全一致;R维护正式四模型比较。完整脚本课前预跑,最后一课仅快速展示数据→描述→筛选→拟合→评价,课后可依据代码与浓缩讲义复现。
All111是异常教学反例;Corrected执行已确认的时间、稀疏/零格、无变异和极低观测比例筛查。旧版T0_102不是最终纠正版。不要用已全训练插补的矩阵做CV,不从测试选变量、调参或选阈值。具体统计边界见教学契约。
通用技术Demo与原有代码片段
以下Demo_R_Project及其数值属于独立技术示范,保留作为片段查阅;本节默认值不覆盖上面的主案例配置。
本章解决什么问题:拿到一份二分类医学数据后,如何用 R 把”读取 → 核查 → 清理 → 描述 → 固定划分”这五步一次做对,并让每一步都有脚本可查、有日志可追、有产物可核对。本章所有数字、表格与图片都来自代码库自带技术演示项目
Demo_R_Project/(演示数据MASS::Pima.tr2)的真实运行结果,已随代码冻结;正文只解释”怎么看、怎么核对”,完整数字以产物文件为准。
Demo_R_Project/ 使用 R 自带 Recommended package MASS 中的 Pima.tr2 二分类数据,作用只有一个:把本章及后续章节所讲的统计纪律用代码严格执行一遍,并把产物冻结下来供你对照。它不是第三个正式教学 Case。正式教学数据只有两套:Myocardial Infarction Complication(直播主案例)与 Early Stage Diabetes Risk Prediction(Mini Project),位于 04_Cases/。把本章方法迁移到正式案例时,替换的是数据与配置,不变的是流程与纪律。
什么时候用
任何二分类预测建模项目,第一步都是本章这套动作:
- 新数据到手,需要先弄清”每列是什么、缺多少、结局怎么编码”;
- 要写论文的 Table 1(基线特征描述表);
- 要开始任何”向数据学习”的步骤(插补、筛选、建模)之前——必须先完成固定划分。
反过来,只要还没冻结划分清单,就不允许做任何会从数据中估计参数的操作。这条顺序是全书防泄漏体系的起点。
输入与输出
输入:二分类数据一份(Demo 直接从 package 加载 MASS::Pima.tr2,不下载文件),外加单一配置源 Demo_R_Project/config/config.R——种子、结局变量名、正类、划分比例、交叉验证(Cross-Validation, CV)折数只在这一处定义,任何脚本不另存第二份。
输出(全部落盘、全部可追溯):
| 类别 | 产物 | 说明 |
|---|---|---|
| 原始快照 | Demo_R_Project/data/raw/demo_raw.csv |
加载后加 row_id,只写一次,之后只读 |
| 清洗队列 | Demo_R_Project/data/derived/cohort_clean.csv |
row_id + 8 个预测变量 + type + y |
| 核查表 | results/tables/ 下 data_dictionary.csv、data_profile.csv、missing_summary.csv |
数据字典、数据画像、缺失汇总 |
| 过程记录 | results/tables/cleaning_log.csv |
每个清理动作一行,含影响行数与规则 |
| 描述表 | results/tables/table1.csv |
Table 1,仅描述,不用于筛变量 |
| 成员清单 | results/tables/split_manifest.csv、fold_manifest.csv |
每行一个 row_id,标注 train/test 与所属 fold |
| 图 | results/figures/outcome_distribution.png、missingness_overview.png |
结局分布、缺失概览 |
| 教材片段 | results/book_fragments/ch02_data_summary.md |
由脚本生成的数字摘要,本章直接引用 |
脚本与产物
| 脚本 | 职责 | 主要产物 |
|---|---|---|
Demo_R_Project/R/01_prepare_data.R |
加载数据、建 row_id、结局校验、数据字典/画像/缺失概览、原始快照 |
data/raw/demo_raw.csv、字典/画像/缺失三表、两张概览图 |
Demo_R_Project/R/02_clean_table1_split.R |
类型与编码核查、清理日志、Table 1、分层划分、fold 成员、一致性断言 | data/derived/cohort_clean.csv、cleaning_log.csv、table1.csv、split_manifest.csv、fold_manifest.csv、ch02_data_summary.md |
Demo_R_Project/config/config.R |
单一配置源(SSOT) | 被所有脚本读取 |
完整实现只在这两个脚本中维护;本章下面只摘录关键片段。整条流水线的唯一总入口是 Demo_R_Project/run_all.R(在 Demo_R_Project/ 目录下执行 Rscript run_all.R),本章对应其中的前两步。
让 Agent 执行
本章任务对应两份可直接复制给 Coding Agent 的 Prompt:
prompts/01_数据读取与核查.md——读取、行标识、结局校验、字典与缺失概览;prompts/02_清理Table1与划分.md——清理日志、Table 1、固定划分与 fold 成员。
使用方式:把对应 Prompt 全文发给 Agent,附上你的数据位置与配置;Agent 按 Prompt 中的”先检查输入并给出简要计划,然后继续执行”约定工作。执行完后不要凭”跑通了”就收货——拿验收清单逐项对账,每个数字都应与产物文件一致。让 Agent 运行 R 的通用方法见 Book 2(文末相关资源)。
核心实现
加载数据与稳定行标识
数据从 package 直接加载,样本量、事件数一律在运行时读取真实结构,不写死。第一件事是建立稳定行标识 row_id——它是后续所有成员清单(manifest)的主键,划分、fold、预测结果都靠它对齐:
data(Pima.tr2, package = "MASS")
raw_df <- as.data.frame(Pima.tr2)
n_total <- nrow(raw_df)
raw_df$row_id <- sprintf("R%04d", seq_len(n_total))
raw_df <- raw_df[, c("row_id", setdiff(names(raw_df), "row_id"))]
结局先校验,不合格就停止
结局变量必须是二分类因子且包含配置中声明的正类,否则脚本直接停止,而不是带着错误编码继续跑:
oc <- raw_df[[config$outcome]]
if (!is.factor(oc) || nlevels(oc) != 2L || !(config$positive_class %in% levels(oc)))
  stop("Outcome check failed: '", config$outcome, "' must be a 2-level factor containing positive class '",
       config$positive_class, "'.")
这种”失败即停”(fail-fast)的断言遍布整个 Demo:输入不符就报错,绝不静默换方法。
原始快照:只写一次,之后只读
data/raw/ 下的原始快照是分析的”原件”:首次运行写入,此后任何重复运行只做一致性校验,不覆盖;校验不过则停止并提示人工处理:
raw_path <- file.path(ROOT, "data", "raw", "demo_raw.csv")
if (file.exists(raw_path)) {
  existing <- readr::read_csv(raw_path, show_col_types = FALSE)
  if (nrow(existing) != n_total || !all(names(existing) == names(raw_df)))
    stop("Existing data/raw/demo_raw.csv is inconsistent with freshly loaded ", config$dataset,
         "; remove it manually if regeneration is intended.")
  log_msg("01 raw snapshot already exists and passed validation; not overwritten.")
} else {
  readr::write_csv(raw_df, raw_path)
  log_msg("01 raw snapshot written: data/raw/demo_raw.csv")
}
清洗后的队列一律写到 data/derived/,原始数据只读这条纪律由此有了物理边界。
编码核查、派生变量与清理日志
02_clean_table1_split.R 中每个处理动作都做两件事:执行处理,并往清理日志追加一行(动作、变量、影响行数、规则)。结局按”负类在前、正类在后”重排因子水平,并生成 0/1 数值结局 y:
cohort[[config$outcome]] <- factor(oc_chr, levels = c(neg_class, config$positive_class))
cohort$y <- make_y(cohort[[config$outcome]])
add_log("recode_outcome", "y", n_total,
        paste0("y = 1 if ", config$outcome, " == '", config$positive_class, "' else 0"))
派生变量 bmi_cat 是技术演示派生变量:用固定切点把连续 bmi 切成三档,用来演示分类变量的编码与后续哑变量处理;规则写死在配置里,不解释为临床阈值:
cohort$bmi_cat <- derive_bmi_cat(cohort$bmi)
add_log("derive_variable", "bmi_cat", sum(!is.na(cohort$bmi_cat)),
"fixed cutpoints <25 / [25,30) / >=30 from bmi; technical demo variable, not a clinical threshold")缺失策略同样只记录、不动手:不按缺失比例自动删任何变量,也不删行;含缺失的变量原样保留,插补值留到训练折内学习(第 3、4 章实现):
miss_counts <- colSums(is.na(cohort[, config$predictors, drop = FALSE]))
for (v in names(miss_counts)[miss_counts > 0])
  add_log("missing_policy", v, unname(miss_counts[v]),
          "kept despite missingness; median/mode imputation learned within training folds only")
Table 1:只描述,不筛变量
Table 1 用 tableone 包按结局分层生成,addOverall = TRUE 给出合计列,missing = TRUE 保留每变量的缺失计数:
tab1 <- tableone::CreateTableOne(vars = config$predictors, strata = config$outcome,
                                 data = as.data.frame(cohort_out), addOverall = TRUE)
tab1_m <- print(tab1, showAllLevels = TRUE, missing = TRUE,
                printToggle = FALSE, noSpaces = TRUE)
tab1_df <- data.frame(term = rownames(tab1_m), tab1_m,
                      row.names = NULL, check.names = FALSE,
stringsAsFactors = FALSE)Table 1 回答的问题是”这个队列长什么样”,不是”哪些变量该进模型”。表中的 p 值列仅供描述队列不平衡程度,不得用来筛变量——变量选择由第 3 章训练集内的 LASSO(Least Absolute Shrinkage and Selection Operator)完成。用 Table 1 的 p 值挑变量,等于让全样本(含测试集)参与了建模决策,是最早、也最常见的一种泄漏。
分层划分与 fold 成员清单
按结局分层,一次性把全队列划成 Training 与留出测试集(Holdout Test),种子只从 config 读取。结果不藏在内存里,而是落成 split_manifest.csv:每行一个 row_id,标注 train 或 test:
set.seed(config$seed)
tr_idx <- caret::createDataPartition(factor(cohort_out$y), p = config$train_prop,
                                     list = FALSE, times = 1)[, 1]
split_vec <- ifelse(seq_len(n_total) %in% tr_idx, "train", "test")
split_manifest <- data.frame(row_id = cohort_out$row_id, split = split_vec,
                             stringsAsFactors = FALSE)
内部验证用的 fold 只在 Training 内部生成,同样按结局分层,落成 fold_manifest.csv:
train_ids <- split_manifest$row_id[split_manifest$split == "train"]
y_train <- cohort_out$y[cohort_out$row_id %in% train_ids]
set.seed(config$seed)
folds <- caret::createFolds(factor(y_train), k = config$outer_folds,
                            list = TRUE, returnTrain = FALSE)
fold_manifest <- do.call(rbind, lapply(seq_along(folds), function(f)
  data.frame(row_id = train_ids[folds[[f]]], fold = f, stringsAsFactors = FALSE)))
两份 manifest 冻结后,后续所有章节(筛选、建模、验证、Python 迁移)都按 row_id 读取同一份成员,不允许任何脚本重新抽样。
一致性断言
划分完成后立刻用断言自证清白:train/test 无交集;fold 成员全部来自训练集;全部 fold 恰好把训练集划分一次:
if (length(intersect(train_ids, test_ids)) > 0L)
  stop("Assertion failed: train/test overlap detected.")
if (!all(fold_manifest$row_id %in% train_ids))
  stop("Assertion failed: fold members outside the training set.")
if (!all(sort(fold_manifest$row_id) == sort(train_ids)))
  stop("Assertion failed: folds do not partition the training set exactly once.")
断言之外还检查 train/test 两侧事件数与对照数均不为零(完整代码见脚本末尾)。断言不过,流水线停止——这正是”核对由代码强制执行”的含义。
实际运行结果
以下摘要由 02_clean_table1_split.R 在运行时自动生成,本章用 include 原样引用,不手抄:
数据摘要 · 本片段由 Demo 脚本自动生成,供教材引用
- 数据来源:
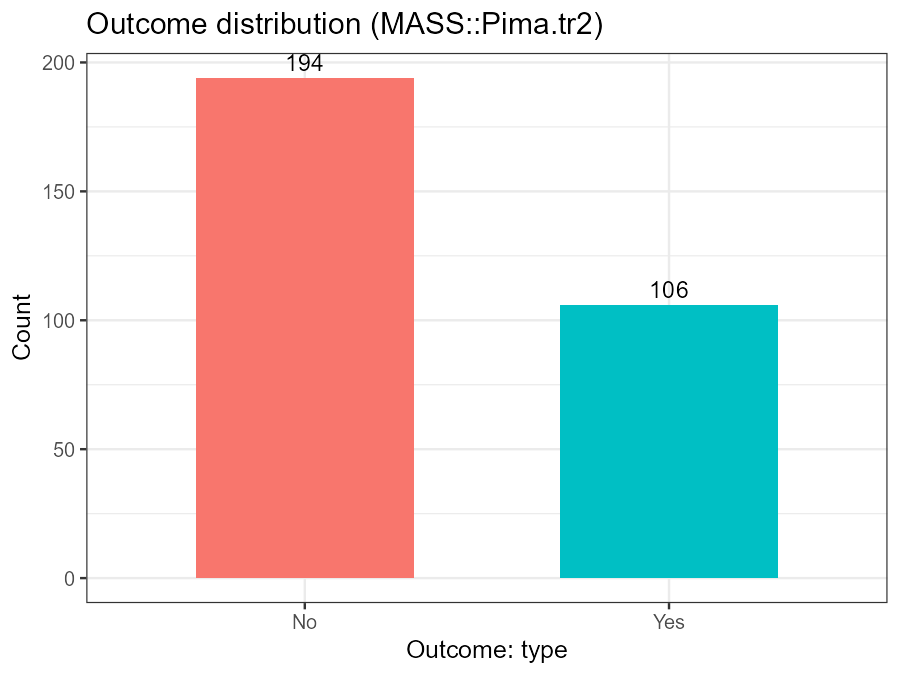
MASS::Pima.tr2(R package 直接加载)。 - 样本量:n = 300;结局
type正类Yes106 例(35.3%)。 - 缺失情况(未按缺失比例删除任何变量,插补仅在训练折内学习):
npreg:0 例缺失(0.0%)glu:0 例缺失(0.0%)bp:13 例缺失(4.3%)skin:98 例缺失(32.7%)bmi:3 例缺失(1.0%)ped:0 例缺失(0.0%)age:0 例缺失(0.0%)bmi_cat:3 例缺失(1.0%)- 派生变量
bmi_cat:技术演示派生变量(固定切点 <25 / [25,30) / >=30),不解释为临床阈值。 - 划分:Training 211 例(事件 75)/ Holdout Test 89 例(事件 31),按结局分层,seed = 20260918。
- 内部验证:Training 内分层 5 折交叉验证;测试集在锁定前不参与任何学习。
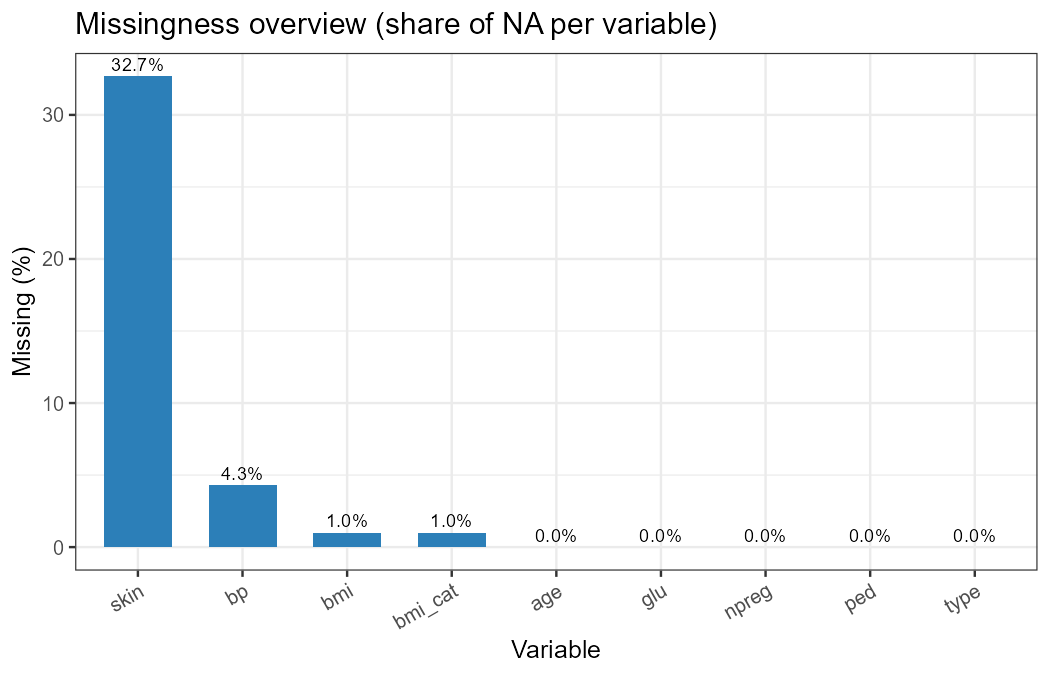
skin 缺失 32.7% 最高,bp 缺失 4.3%,bmi 与派生变量 bmi_cat 各缺失 1.0%,其余变量无缺失。
Table 1 的连续变量关键行摘要见 表 2.1;分类变量 bmi_cat 的完整分布与全部检验信息见完整表 Demo_R_Project/results/tables/table1.csv。
Demo_R_Project/results/tables/table1.csv。
| 变量 | Overall(n=300) | No(n=194) | Yes(n=106) | p | 缺失(%) |
|---|---|---|---|---|---|
| npreg, mean (SD) | 3.79 (3.31) | 3.24 (2.93) | 4.79 (3.71) | <0.001 | 0.0 |
| glu, mean (SD) | 123.74 (30.01) | 113.02 (24.90) | 143.37 (28.71) | <0.001 | 0.0 |
| bp, mean (SD) | 72.32 (11.70) | 70.80 (11.39) | 75.26 (11.80) | 0.002 | 4.3 |
| skin, mean (SD) | 29.15 (11.68) | 27.14 (10.86) | 33.12 (12.30) | 0.001 | 32.7 |
| bmi, mean (SD) | 32.05 (6.49) | 30.67 (6.55) | 34.58 (5.59) | <0.001 | 1.0 |
| ped, mean (SD) | 0.44 (0.29) | 0.40 (0.26) | 0.51 (0.33) | 0.002 | 0.0 |
| age, mean (SD) | 33.10 (11.58) | 31.11 (11.37) | 36.73 (11.12) | <0.001 | 0.0 |
结果怎么读
核查三表(字典 / 画像 / 缺失)。data_dictionary.csv 写明每列的类型、角色与是否派生——它是判断”这列该按连续还是分类处理”的唯一依据;data_profile.csv 给出每变量的样本量、缺失数、均值与标准差(或因子水平计数);missing_summary.csv 把缺失单独汇总。拿到任何新数据,先按这三表回答”每列是什么、缺多少”,再谈清理。
清理日志。cleaning_log.csv 共 9 条记录,覆盖:加载快照、类型核查、结局重编码、派生 bmi_cat、四个变量的缺失策略、不过滤任何行(row_filter 影响 0 行)、row_id 唯一性检查。读它的方式是逐行问三个问题:做了什么?影响了多少行?依据的规则写在哪?答不上来的动作就不该存在。
Table 1。mean (SD) 即均值(标准差);分类变量给列内百分比;Missing 列是该变量的缺失占比,提醒读者描述基于非缺失部分。本队列中 bmi_cat 三档在事件组的分布为 2.9% / 14.3% / 82.9%,非事件组为 20.8% / 28.6% / 50.5%(p<0.001,详见完整 CSV)——这是对队列的描述,是否入模、以什么形式入模,由训练集内的筛选流程另行决定。
成员清单。split_manifest.csv 共 300 行:Training 211 例(事件 75)、Holdout Test 89 例(事件 31),按结局分层(训练比例 0.70,seed = 20260918),两侧事件率都接近全队列的 35.3%,这是”按结局分层”的直接证据。fold_manifest.csv 共 211 行,5 折,各折 43 / 42 / 42 / 42 / 42 例,全部来自 Training。测试集从这一刻起冻结:不参与插补学习、不参与筛选、不参与调参与阈值选择,直到第 5 章模型锁定后只被评价一次。
验收清单
让 Agent 跑完本章两步后,逐项核对(括号内为 Demo 的冻结数字,迁移到自己的数据时换成你的运行值):
data/raw/demo_raw.csv存在且未被二次运行覆盖;row_id从 R0001 连续编号、无重复(n = 300)。- 结局校验通过:正类
Yes106 例(35.3%);若结局不是二分类因子,脚本应当已经停止。 missing_summary.csv与运行日志一致:bp13 例、skin98 例、bmi3 例、bmi_cat3 例,其余为 0。cleaning_log.csv每个动作一行,row_filter行的影响行数为 0——没有删任何行,也没有按缺失比例删任何变量。cohort_clean.csv列结构为row_id+ 8 个预测变量 +type+y,行数与原始快照一致。table1.csv含Overall、No、Yes、p、test、Missing列;No列合计 194、Yes列合计 106,与结局计数一致。split_manifest.csv共 300 行:train 211 / test 89,事件 75 / 31;train 与 test 无交集(断言保证)。fold_manifest.csv共 211 行、5 折,各折 43 / 42 / 42 / 42 / 42 例;全部row_id属于 train,且合起来恰好覆盖 train 一次。- 两张图与教材片段已生成,数字与本节引用一致。
常见错误
用全体数据算中位数插补、算均值标准化、筛完变量,然后再划分训练/测试——这套顺序让测试集的信息提前进入了训练过程,后续所有验证结果都会偏乐观。正确顺序永远本章这样:先冻结 split/fold manifest,一切”学习”只在 Training(及其 fold)内进行。
- 按缺失比例删变量或删行。
skin缺 32.7% 仍被保留:缺失率是调查线索,不是删除门槛;删行还会系统性丢掉某类患者。 - 用 Table 1 的 p 值筛变量。 描述与筛选必须分离;筛选属于第 3 章,且只用训练集。
- 手工编辑
data/raw/快照。 原件被改后一切不可复现;快照只读,改动只能发生在data/derived/。 - 在多个脚本里各写一份种子或折数。 第二份配置必然漂移;种子、比例、折数只能来自
config/config.R。 - 把随机 Holdout Test 当成外部验证。 它只是同来源数据的留出部分;外部验证需要独立来源的数据,本章不涉及。
复用时替换什么
迁移到自己的数据(包括两套正式教学案例)时,只换这些,其余结构原样保留:
- 配置:
config/config.R中的dataset、outcome、positive_class、predictors_numeric/predictor_factor、seed、train_prop、outer_folds。 - 数据入口:把
01_prepare_data.R中的data(Pima.tr2, package = "MASS")换成读取你自己的文件(如readr::read_csv()),其后row_id、校验、快照逻辑不变。 - 字典文本:
data_dictionary.csv的变量描述按你的数据改写。 - 派生变量:不需要分类演示变量时删除
bmi_cat及其配置;需要时换成你研究方案里预先写死的规则,并同样注明规则来源。 - 不要改:manifest 的两表结构、一致性断言、清理日志机制、raw 只读纪律——它们是被反复验证过的防泄漏骨架。
相关资源
- 概念与判断(为什么字典先行、为什么划分先于学习):Book 1 第2章 临床数据准备与描述统计。
- 让 Agent 干活的方法:Book 2 第3章 把任务交给 Agent、第5章 让 Agent 使用 R 与 Python、第6章 出错了怎么办。
- 本章配套 Prompt(可复制全文发给 Agent):
prompts/01_数据读取与核查.md、prompts/02_清理Table1与划分.md。 - 正式教学案例目录:
04_Cases/Myocardial_Infarction_Complications/(直播主案例)、04_Cases/Early_Stage_Diabetes_Risk_Prediction/(Mini Project)。 - 后续章节导航:Book 3 首页。