第3章 LASSO 变量筛选、Logistic 重拟合与 Nomogram
现行主案例执行入口(2026-09-19)
Myocardial_Infarction_Complications的唯一执行根位于仓库 04_Cases/Myocardial_Infarction_Complications/,参数由analysis_config.R维护。按案例运行指南执行,不能复制本章技术Demo的变量、折数或数值替代主案例。
| 任务 | 主案例脚本 |
|---|---|
| 读取与描述、固定成员 | L01_Read_Check_Demo.R、L02_Data_Preparation.R |
| LASSO lambda.min按原始变量筛选、普通Logistic | L03_Feature_Selection_Logistic.R |
| 完整训练内筛选/调参的外层OOF | L04_Internal_Validation.R |
| 共享特征的RF/XGBoost/SVM与SHAP | L05_ML_Comparison_SHAP.R |
| 第5课集中纠错、Kappa冻结与留出对照 | L06_Data_Audit_T0_Correction.R |
| 单变量整体LRT与AIC机制展示 | Teacher_Selection_Demonstrations.R |
| 冻结系数列线图及验证 | Export_Classroom_Artifacts.R、Validate_Review_Run.R、Check_Separation.py |
| Python完整统计主链快速展示 | Export_Python_Raw.R、Python_Statistical_Workflow.py |
Python演示保留原始缺失与固定成员,在各训练范围独立筛查、插补和选择lambda.min,再按原始变量拟合普通Logistic,训练OOF最大Kappa阈值冻结后用于测试。使用scikit-learn 1.9的SAGA,与R glmnet内层实现不同,不要求数值完全一致;R维护正式四模型比较。完整脚本课前预跑,最后一课仅快速展示数据→描述→筛选→拟合→评价,课后可依据代码与浓缩讲义复现。
All111是异常教学反例;Corrected执行已确认的时间、稀疏/零格、无变异和极低观测比例筛查。旧版T0_102不是最终纠正版。不要用已全训练插补的矩阵做CV,不从测试选变量、调参或选阈值。具体统计边界见教学契约。
通用技术Demo与原有代码片段
以下Demo_R_Project及其数值属于独立技术示范,保留作为片段查阅;本节默认值不覆盖上面的主案例配置。
本章解决什么问题:候选变量集已定、训练集已冻结之后,如何在训练集内做一次有纪律的变量筛选,并把筛选结果变成一个可解释、可报告、可画 Nomogram 的模型。主线只有一条:LASSO(Least Absolute Shrinkage and Selection Operator)选出非零 dummy → 映射回原始变量 → 无惩罚 Logistic 回归(Logistic Regression)重新拟合 → 报告 OR(Odds Ratio,比值比)与 95% CI(Confidence Interval,置信区间)→ 画 Nomogram。
本章定位: 本章精讲 Demo 脚本 Demo_R_Project/R/03_lasso_logistic_nomogram.R,回答三件事:LASSO 筛选的每一环在做什么、怎么让 Agent 原样运行它、运行后拿哪些数字核对。示例为技术 Demo:MASS::Pima.tr2(R Recommended package 直接加载,n = 300、事件 106,见 Demo_R_Project/results/run_summary.md),只用于演示代码与产物,不是第三个正式教学 Case——正式教学数据只有 Myocardial Infarction Complication(直播主案例)与 Early Stage Diabetes Risk Prediction(Mini Project),Demo 数字不进入任何正式教学口径。logit、OR、参照组等概念本身见讲义 Logistic 候选模型,本章只给最小提示,重心在代码与产物。
什么时候用
适合用本章流程的场景:
- 候选变量相对事件数偏多、参数预算紧张(EPV,events per variable,每变量事件数不足),希望自动收缩而不是逐个凭 P 值取舍;
- 需要一个透明、可解释、可审计的主线模型:筛选规则固定,能在交叉验证(CV,Cross-Validation)的每个训练折内被原样复制;
- 变量中混有连续量与分类量,需要”dummy 级筛选、变量级报告”的规范映射。
不适合、请换章节的情况:
- 候选变量很少且事件充足——直接按预设变量集拟合即可,筛选反而引入数据驱动的不稳定(讲义 Logistic 候选模型 的对照讨论);
- 目标是纯预测性能、可接受黑箱——见第 5 章机器学习比较;
- 想回答”这个模型好不好”——见第 4 章内部验证。本章产物是一个开发完毕的模型,本身不带任何性能证据。
输入与输出
输入(全部来自前序章节与单一配置源)
| 输入 | 说明 |
|---|---|
Demo_R_Project/data/derived/cohort_clean.csv |
清理后队列(第 2 章产物) |
Demo_R_Project/results/tables/split_manifest.csv |
划分成员表;本章只读取 split == "train" 的行(Demo 实跑:train n = 211、事件 75) |
Demo_R_Project/config/config.R |
预测变量集合、结局 type 与正类 Yes、种子、lasso_lambda = "lambda.min"、inner_folds = 5 |
输出(全部在训练集范围内生成)
| 产物 | 内容 |
|---|---|
results/tables/lasso_coefficients.csv |
全部 9 个 dummy 的 LASSO 惩罚系数(含被压到 0 的),仅用于筛选 |
results/tables/lasso_selected_terms.csv |
入选 dummy 清单(7 行) |
results/tables/lasso_selected_variables.csv |
dummy → 原始变量映射表(7 个变量) |
results/tables/logistic_or_ci.csv |
重拟合模型的 log(OR)、OR、95% CI、P 值(9 行,含截距) |
results/figures/lasso_path.png / lasso_cv.png |
LASSO 系数路径图与交叉验证曲线 |
results/figures/logistic_or_forest.png / nomogram.png |
OR 森林图与 Nomogram |
results/models/lasso_mainline.rds |
训练集预处理对象 + 入选变量 + lambda + 最终 glm(供第 5 章锁定复用) |
results/book_fragments/ch03_lasso_summary.md / ch03_logistic_summary.md |
供教材引用的结果片段(本章”实际运行结果”一节直接 include) |
每个产物都登记在 results/artifact_manifest.csv,可追溯生成脚本、来源数据与分析范围(training set)。
脚本与产物
唯一脚本:Demo_R_Project/R/03_lasso_logistic_nomogram.R(约 220 行),由 run_all.R 统一调度,也可在 Demo_R_Project 根目录单独执行 Rscript R/03_lasso_logistic_nomogram.R。六个工序依次是:
- 读取队列与成员表,只保留训练集行;
- 训练集预处理:中位数/众数插补、因子编码,参数只在训练集学习;
cv.glmnet做 LASSO,按配置取lambda.min;- 非零 dummy 映射回原始变量;
- 用入选原始变量重拟合无惩罚
glm,计算 OR 与 95% CI; - 出四张图与 Nomogram,写教材片段。
预处理函数 fit_preprocessor() / apply_preprocessor()、设计矩阵函数 build_design() 与映射函数 map_terms_to_variables() 统一定义在 Demo_R_Project/R/00_setup.R——一处定义、多章复用,这是折内口径一致性的代码保障。依赖 glmnet、rms、ggplot2 等(Demo 实跑 R 4.5.2、glmnet 4.1.10;完整版本见 results/logs/sessionInfo.txt)。
让 Agent 执行
让 Agent 运行本脚本,标准说法是给出脚本路径、运行目录、约束与验收数字。本脚本只做训练集内的筛选与拟合,不做性能评价、不碰测试集。
让 Agent 运行本章脚本并核对产物。替换方括号后整体复制发送;完整版 Prompt 见 prompts/03_LASSO与Logistic.md。
【背景】我在做一个二分类预测模型项目。数据已完成清理与训练/留出测试划分,
有 split 成员表;预测变量集合、结局、正类、种子、lambda 规则集中在配置文件。
【当前任务】在 Demo_R_Project 根目录运行:Rscript R/03_lasso_logistic_nomogram.R
只做训练集内的 LASSO 变量筛选、原始变量映射、无惩罚 Logistic 重拟合、OR/CI 与 Nomogram。
先检查输入并给出简要计划,然后继续执行指定任务;不要在计划后等待用户再次确认。
只有输入冲突、字典冲突、必须改变方法或命中暂停条件时停止。
【约束】1. 原样运行,不改代码、种子、折数与 lambda 规则;
2. 只用 split == "train" 的行;插补/编码/标准化参数只在训练集学习;
3. LASSO 惩罚系数只用于筛选;最终效应量必须来自无惩罚 glm 重拟合,
   不得按 P 值对入选变量二次增删;
4. 不做单变量筛选或 Stepwise,更不允许把它们的入选变量与 LASSO 结果合并;
5. 结果数字以实际运行输出为准,不得凭记忆填写。
【输出要求】报告 4 张 CSV、4 张 PNG、lasso_mainline.rds 与两个 book fragment 的完整路径。
【验收】逐项报告:lambda.min;设计矩阵 dummy 总数、入选 dummy 数、映射回原始变量数、
最终系数数(含截距);入选变量名单;CI 方法;glm 收敛与分离标志。
【暂停条件】LASSO 无入选变量、glm 不收敛或出现分离警告、CI 非有限——
任一发生即停止并报告证据,不自行换方法。
运行成功后进入核对关口:按下文”验收清单”逐项对数。若数字不符,让 Agent 先贴证据(控制台输出、文件内容)再提修改,修改仅限环境与路径——不允许以”修复”为名改种子、lambda 规则或变量名单。
核心实现
三个数不能混:dummy 数、原始变量数、系数数
本章最容易乱的是三个计数。设计矩阵的列(dummy):连续变量各占一列,分类变量按非参照水平展开成多个 dummy;入选原始变量数:非零 dummy 映射回的变量个数;最终模型系数数:重拟合后公式里所有项(含截距、含分类变量的全部非参照水平)。本章实例是 9 个候选 dummy → 7 个入选 dummy → 7 个原始变量 → 9 个系数(含截距)——两个 7 是巧合,数的是三种不同的东西。核对任何产物前,先问”这个数在数什么”。
分类变量的保留规则必须钉死:任一非参照 dummy 入选,即保留整个原始变量。本例 bmi_cat 只有 bmi_ge30 的 dummy 入选,但重拟合时 bmi_cat 整体进入公式,两个非参照水平都会回到模型里——这保证编码结构与参照组不被筛选动作破坏。
LASSO:cv.glmnet 与 lambda.min
03_lasso_logistic_nomogram.R(摘录 1:设计矩阵与 cv.glmnet)
design <- build_design(train_imp, config$predictors)
X_train <- design$X
y_train <- train_imp$y
set.seed(config$seed)
cvfit <- glmnet::cv.glmnet(X_train, y_train, family = "binomial",
                           nfolds = config$inner_folds)
lambda_use <- cvfit[[config$lasso_lambda]]   # "lambda.min"
if (!is.finite(lambda_use)) stop("cv.glmnet returned non-finite ", config$lasso_lambda)
coef_mat <- as.matrix(stats::coef(cvfit, s = config$lasso_lambda))三个细节。第一,glmnet 只接受数值矩阵,build_design() 用 model.matrix 展开因子、去掉截距列,并保存”列 → 原始变量”的映射 col_var——后面的变量映射全靠这张表;第二,种子与折数(5 折)都来自单一配置源 config.R,脚本里没有第二份;第三,lambda 规则锁定为 lambda.min,它不是”试到结果好看为止”的旋钮——要换 lambda.1se,改配置、留记录、全链条重跑。
从 dummy 回到原始变量
03_lasso_logistic_nomogram.R(摘录 2:非零 dummy 判定与变量映射)
coef_df$variable <- unname(design$col_var[coef_df$term])
coef_df$selected <- abs(coef_df$coefficient) > .Machine$double.eps

sel_terms_df <- coef_df[coef_df$selected, , drop = FALSE]
if (nrow(sel_terms_df) == 0L)
  stop("LASSO selected no variables at ", config$lasso_lambda,
       "; aborting (no silent fallback allowed).")
selected_vars <- map_terms_to_variables(sel_terms_df$term, design$col_var)
n_sel_dummies <- nrow(sel_terms_df)
n_sel_vars <- length(selected_vars)入选判定用数值非零(.Machine$double.eps),不是”系数看起来很小就算剔除”。映射函数本身只有一行核心逻辑,定义在 00_setup.R:
00_setup.R(map_terms_to_variables 定义)
map_terms_to_variables <- function(selected_terms, col_var) {
  unique(unname(col_var[selected_terms]))
}
lasso_selected_variables.csv 落盘的就是这张映射表(每个变量带了哪些入选 dummy)。注意脚本的硬闸门:LASSO 一个变量都没选出来时直接停止,而不是”换个 lambda 再试试”——零入选是数据与方法的结论,需要人来决策,不是脚本静默绕过的理由。
Logistic 必须重新拟合
LASSO 的系数被人为向 0 收缩,是有偏估计,也没有可用的标准误、P 值与置信区间——它唯一的合法用途是筛选。要报告效应量(OR 与 CI),必须用入选变量重新拟合无惩罚的 glm,让估计与推断都回到标准 Logistic 框架。直接把惩罚系数取指数当 OR 报告,是本章最常见的硬伤。
03_lasso_logistic_nomogram.R(摘录 3:glm 重拟合与收敛/分离闸门)
fml <- stats::as.formula(paste("y ~", paste(selected_vars, collapse = " + ")))
separation_flag <- FALSE
glm_warnings <- character()
fit_glm <- withCallingHandlers(
  stats::glm(fml, data = train_imp, family = stats::binomial),
  warning = function(w) {
    glm_warnings <<- c(glm_warnings, conditionMessage(w))
    if (grepl("fitted probabilities numerically 0 or 1", conditionMessage(w)))
      separation_flag <<- TRUE
    invokeRestart("muffleWarning")
  })
if (length(glm_warnings) > 0L)
  log_msg("03 glm warnings: ", paste(glm_warnings, collapse = " || "))
if (!fit_glm$converged) stop("Final logistic model did not converge; aborting.")
if (separation_flag) stop("Separation detected in final logistic model; aborting (no silent method switch).")公式由入选原始变量拼成(y ~ npreg + glu + bp + bmi + ped + age + bmi_cat),bmi_cat 作为因子整体进入,R 自动按参照水平展开 dummy。withCallingHandlers 把拟合中的警告拦截下来检查:不收敛或出现分离(fitted probabilities numerically 0 or 1)即停止并报告——不静默换 Firth、不悄悄删变量,换方法属于设计变更,必须先记录再决策。
OR 与 95% CI:profile likelihood 优先
03_lasso_logistic_nomogram.R(摘录 4:CI 计算与方法记录)
ci_method <- "profile_likelihood"
ci_mat <- tryCatch(suppressMessages(stats::confint(fit_glm)),
                   error = function(e) NULL)
if (is.null(ci_mat) || any(!is.finite(ci_mat))) {
  ci_method <- "wald"
  ci_mat <- stats::confint.default(fit_glm)
}
if (any(!is.finite(ci_mat)))
  stop("Non-finite confidence interval in final logistic model; aborting.")
confint() 默认给出 profile likelihood(轮廓似然)区间,在系数较大或样本不富裕时比 Wald 区间更稳;只有它失败才回退 Wald,并把实际方法写进 logistic_or_ci.csv 的 ci_method 列。核对产物时这一列必须是 profile_likelihood;CI 出现非有限值同样直接停止。
Nomogram:表达工具,不是验证证据
03_lasso_logistic_nomogram.R(摘录 5:rms Nomogram)
dd <- rms::datadist(train_imp)
old_dd <- getOption("datadist")
options(datadist = "dd")
fit_lrm <- rms::lrm(fml, data = train_imp, x = TRUE, y = TRUE)
nom <- rms::nomogram(fit_lrm, fun = stats::plogis, fun.at = seq(0.1, 0.9, 0.1),
                     lp = FALSE, funlabel = "P(type = Yes)")
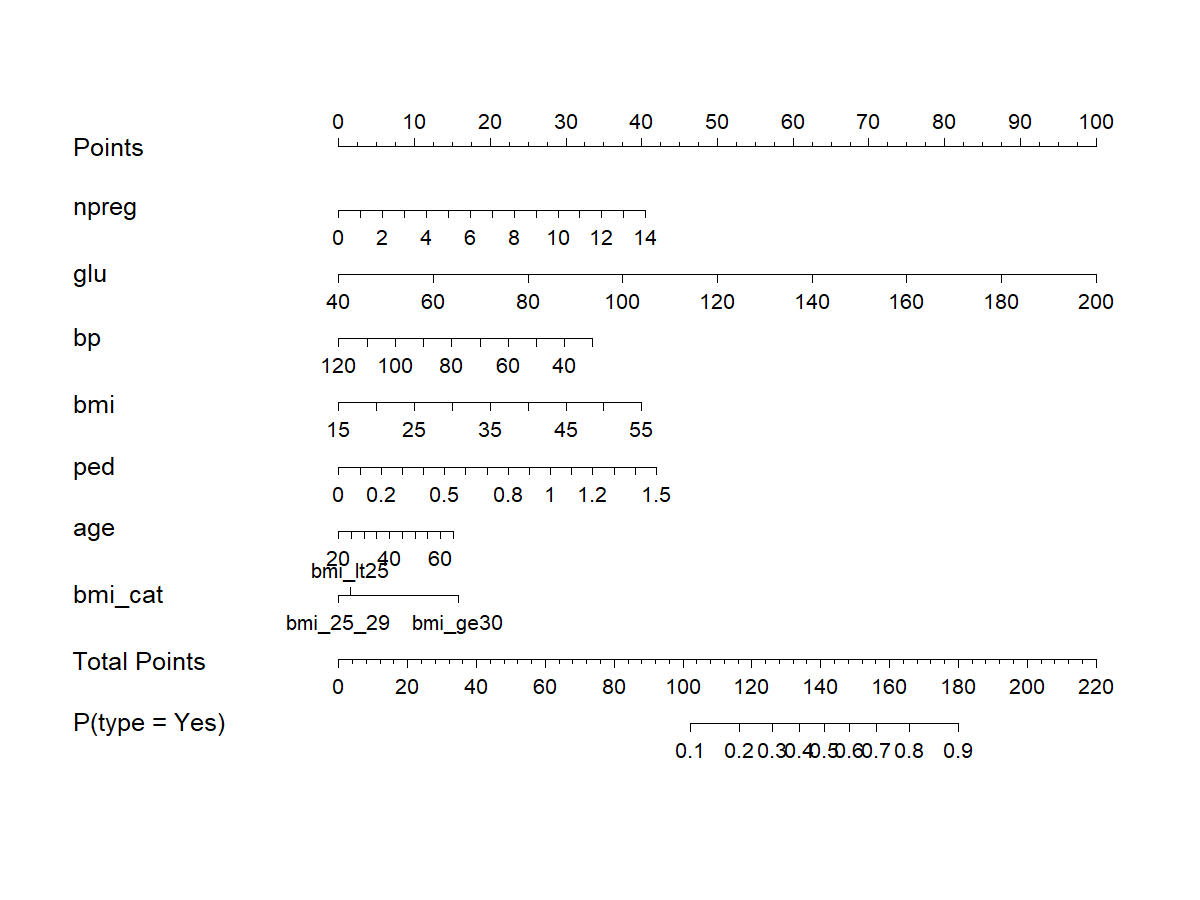
rms::lrm() 用同一公式、同一数据重拟合(与 glm 结果一致,只是换成 rms 体系),datadist 提供变量分布摘要,fun = plogis 把总分映射回预测概率 P(type = Yes)。Nomogram 的价值是把模型变成一张可读、可手工打分的图;它不提供任何性能证据——模型好不好,是第 4 章内部验证回答的问题。
单变量筛选与 Stepwise:只作方法对照,不回流主模型
单变量 P 值筛选、Stepwise 与 LASSO 是三条常见筛选路线,它们在同一批数据上常给出不同名单——这种不一致本身就是数据驱动筛选不稳定的证据(对照讨论见讲义 Logistic 候选模型)。本代码库的纪律:
- 主线只有 LASSO 一条链,入选集合以
lambda.min处的非零 dummy 为准; - 单变量筛选与 Stepwise 的结果至多作为方法对照出现在讨论中,本章不提供对照实现;
- 不得把对照路线的入选变量与 LASSO 结果求并集或交集;
- 任何对照路线选出的变量都不得回流主模型。
理由有三:多重数据驱动选择会放大过拟合且无法审计;一条链才能在每个 CV 折内被完整复制(第 4 章逐折重做 LASSO,对照路线做不到同步复制);混合名单无法回答”这个变量是哪条规则放进来的”。想比较三条路线的结论差异,去读讲义;想让模型可审计、可复现,守住这一条链。
实际运行结果
以下数字全部由 R/03_lasso_logistic_nomogram.R 在 Demo 训练集(n = 211、事件 75)上真实运行生成并冻结;重跑 Demo 时若与这些数字不符,先按”验收清单”排查,不要默认”差不多就行”。
LASSO 筛选结果
LASSO 变量筛选摘要 · 本片段由 Demo 脚本自动生成,供教材引用
- 设计矩阵 dummy 总数:9(含
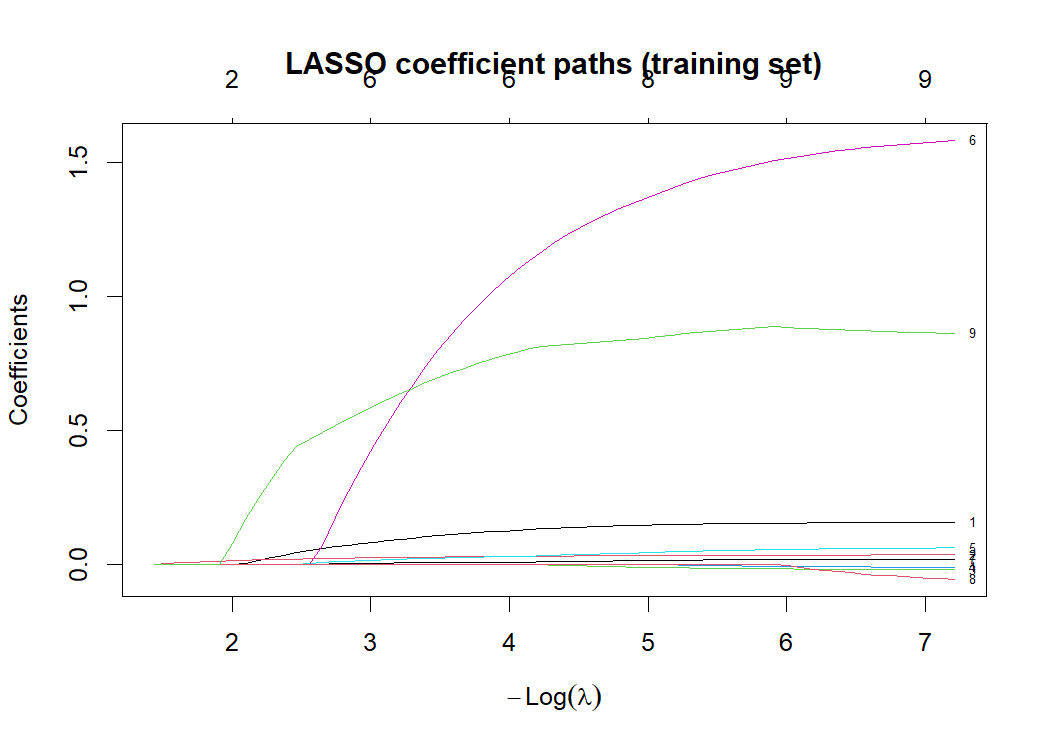
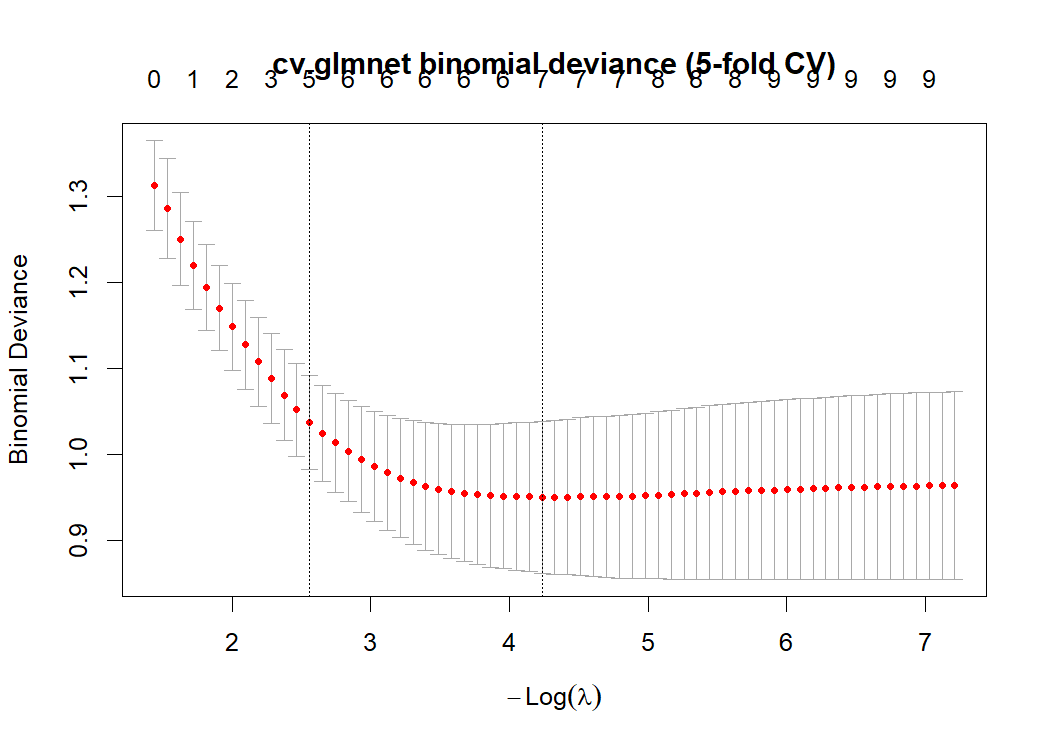
bmi_cat的非参照水平)。 cv.glmnet(family = binomial,5 折)选择lambda.min= 0.0144691。- 入选 dummy 数:7;映射回原始变量数:7;最终 Logistic 系数数(含截距):9。
- 入选原始变量:
npreg、glu、bp、bmi、ped、age、bmi_cat。 - 说明:LASSO 惩罚系数仅用于筛选;最终效应量来自无惩罚
glm重拟合。
图 3.1 展示每个 dummy 的惩罚系数随 log(lambda) 收缩的路径,虚线位于 log(lambda.min);图 3.2 是 cv.glmnet 的 5 折交叉验证曲线,二项偏差的最低点对应 lambda.min = 0.0144691。
最终 Logistic 模型
最终 Logistic 模型 · 本片段由 Demo 脚本自动生成,供教材引用
无惩罚 glm 重拟合(LASSO 仅用于筛选)。CI 方法:profile_likelihood。
| 项 | log(OR) | OR | 95% CI | P 值 |
|---|---|---|---|---|
| (Intercept) | -7.9811 | 0.000 | 0.000-0.008 | 0.0000 |
| npreg | 0.1632 | 1.177 | 1.037-1.346 | 0.0138 |
| glu | 0.0352 | 1.036 | 1.023-1.051 | 0.0000 |
| bp | -0.0210 | 0.979 | 0.944-1.015 | 0.2480 |
| bmi | 0.0564 | 1.058 | 0.963-1.165 | 0.2413 |
| ped | 1.5766 | 4.839 | 1.259-20.001 | 0.0246 |
| age | 0.0189 | 1.019 | 0.977-1.063 | 0.3751 |
| bmi_catbmi_25_29 | -0.0861 | 0.918 | 0.190-5.298 | 0.9172 |
| bmi_catbmi_ge30 | 0.8059 | 2.239 | 0.380-15.456 | 0.3862 |
- 模型收敛:TRUE;分离警告:FALSE。
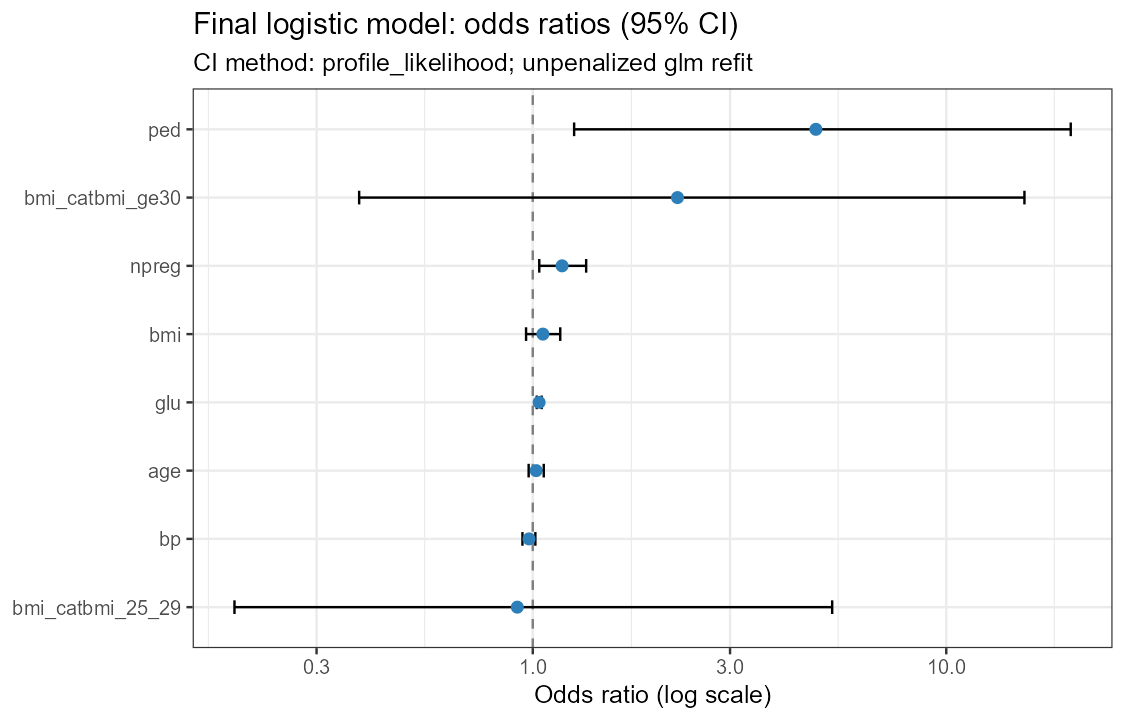
图 3.3 把上表画成森林图:log 刻度,误差线为 profile likelihood 95% CI,横线跨过 1 表示方向不确定。图 3.4 是基于同一模型画出的 Nomogram。
结果怎么读
- 三个数的实际口径:候选 9 个 dummy(7 个连续变量 +
bmi_cat的 2 个非参照水平)→lambda.min= 0.0144691 处 7 个非零 dummy(skin与bmi_catbmi_25_29被压到 0)→ 7 个原始变量(skin整体出局;bmi_cat凭bmi_ge30一个 dummy 按规则保留)→ 重拟合 9 个系数(截距 + 6 个连续变量 +bmi_cat的 2 个水平)。lasso_coefficients.csv里skin的系数是 0、selected = FALSE,这就是”被剔除”的落盘形态。 - OR 表读法:
gluOR = 1.036(1.023–1.051)、npregOR = 1.177(1.037–1.346)、pedOR = 4.839(1.259–20.001,区间很宽)有统计学关联;bp、bmi、age的区间跨过 1——它们留在模型里是因为 LASSO 选了它们,预测模型的变量去留由筛选规则决定,不按 P 值二次筛选。bmi_cat两个水平区间很宽,反映分组后格子样本有限,不作临床解释。 - 图读法:路径图看”谁先被压到 0”;CV 曲线看最低点位置;森林图看区间与 1 的关系;Nomogram 按各变量读 Points、加总、映射概率。
- Demo 数字的边界:
bmi_cat是技术演示派生变量,其分组切点是演示用固定规则,不解释为临床阈值;本页所有数字只用于复跑核对,不得外推为任何人群的风险证据。
验收清单
运行成功后按此表逐项核对(参考值为 Demo 实跑结果,出自 fragment 与 CSV):
| 核对项 | 参考值 | 不对时怀疑什么 |
|---|---|---|
lambda.min |
0.0144691 | 种子或折数被改;glmnet 版本差异 |
| 设计矩阵 dummy 总数 | 9 | 因子水平变化;bmi_cat 没建成 3 水平 |
| 入选 dummy 数 | 7 | lambda 规则被换成 lambda.1se |
| 入选原始变量数与名单 | 7:npreg、glu、bp、bmi、ped、age、bmi_cat(无 skin) |
dummy → 变量映射丢失;把 dummy 数当变量数 |
| 最终系数数(含截距) | 9 | 按入选 dummy 重拟合(bmi_cat 只剩一个水平,编码结构被破坏) |
| CI 方法 | profile_likelihood(查 ci_method 列) |
回退到了 Wald,需查原因 |
| 收敛与分离 | 收敛 TRUE、分离警告 FALSE | 数据或编码异常 |
| 产物齐全 | 4 表 + 4 图 + lasso_mainline.rds + 2 个 fragment |
路径或权限问题;脚本未跑完 |
常见错误
- 拿 LASSO 惩罚系数直接算 OR 报告。 惩罚系数有偏、无正式推断,只能用于筛选;效应量一律来自无惩罚
glm重拟合。 - 按入选 dummy 重拟合。 症状:
bmi_cat只剩bmi_ge30一个水平,系数数对不上。正确做法是按原始变量重拟合,让分类变量所有非参照水平回到模型。 - 报告”入选 9 个变量”。 把 dummy 数当变量数;本章口径是 9 dummy → 7 变量 → 9 系数。
- 按 P 值删掉
bp、bmi、age。 这是对入选集合的二次数据驱动筛选;变量去留在 LASSO 一步已经完成。 - 让 glmnet 直接吃因子列。
glmnet需要数值设计矩阵;必须先model.matrix展开并保留col_var映射,否则无法回到原始变量。 - 临时把
lambda.min换成lambda.1se“让模型更简洁”。 规则在config.R锁定;要改就改配置、留记录、全链条重跑。 - 用全队列(含测试集)跑 LASSO。 这是泄漏;本章脚本只读
split == "train"的行,测试集直到第 5 章锁定后才被读取一次。 - 把 Nomogram 当模型好用的证据。 它是表达工具;性能证据只能来自第 4 章的折外预测与第 5 章的留出测试。
- 把单变量显著而 LASSO 未选的变量”补回来”。 对照路线不回流主模型(见上节纪律)。
- 分离警告后静默换方法。 脚本的设计是停止并报告;Firth、删变量、并格子都属于设计变更,先记录再决策。
复用时替换什么
- 数据与结局:换
config.R的dataset、outcome、positive_class,并保证第 1、2 章产物(清理队列、成员表)已按新数据生成; - 预测变量集合与类型:
predictors_numeric/predictor_factor;bmi_cat是技术演示派生变量,正式项目里替换或删除其派生规则(bmi_cat_breaks/bmi_cat_labels); - 预处理细节:
00_setup.R的fit_preprocessor()/apply_preprocessor()(插补值与因子水平规则); - lambda 规则与折数:
lasso_lambda、inner_folds; - Nomogram 标签:
funlabel、fun.at; - 换正式案例(Myocardial Infarction Complication 或 Early Stage Diabetes Risk Prediction,见
../../04_Cases/)后必须整条run_all.R重跑,所有数字以新运行为准——Demo 数字只用于演示,不得沿用进正式案例。
相关资源
- 本章脚本:
Demo_R_Project/R/03_lasso_logistic_nomogram.R;预处理与映射函数:Demo_R_Project/R/00_setup.R;参数单一来源:Demo_R_Project/config/config.R - 产物登记与追溯:
Demo_R_Project/results/artifact_manifest.csv;完整 Prompt:prompts/03_LASSO与Logistic.md - 概念讲义:Logistic 候选模型(logit/OR/筛选路线对照)、模型评价与内部验证(下一步)
- Agent 协作:把任务交给 Agent、让 Agent 使用 R 与 Python
- 扩展阅读:glmnet 包 https://cran.r-project.org/package=glmnet;rms 包 https://cran.r-project.org/package=rms
进入第 4 章:把本章整条链(训练集预处理 → LASSO → 原始变量映射 → Logistic 重拟合)放进每个 outer 训练折内完整重跑,用折外(out-of-fold, OOF)预测计算 ROC、校准与 DCA——内部验证评价的是这套流程的期望表现,而不是这一个模型的表观分数。