flowchart TD
    A[训练集 211 例] --> B[5 折 outer CV 骨架<br/>与第 4 章同一批 fold_manifest]
    B --> C[折内重学预处理 + 重做 LASSO<br/>同一折 4 个模型共享该折变量集]
    C --> D[内层 5 折 CV 小网格调参<br/>与 outer 评价严格分离]
    D --> E[合并各模型 OOF 预测<br/>按预设规则选模]
    E --> F[锁定:模型 + 预处理 + 超参数 + 阈值<br/>三件套落盘]
    F --> G[Holdout Test 89 例<br/>一次性评价]
    G -.测试后.-> H[不返回重选<br/>不调阈值]
第5章 机器学习比较、解释与最终测试
现行主案例执行入口(2026-09-19)
Myocardial_Infarction_Complications的唯一执行根位于仓库 04_Cases/Myocardial_Infarction_Complications/,参数由analysis_config.R维护。按案例运行指南执行,不能复制本章技术Demo的变量、折数或数值替代主案例。
| 任务 | 主案例脚本 |
|---|---|
| 读取与描述、固定成员 | L01_Read_Check_Demo.R、L02_Data_Preparation.R |
| LASSO lambda.min按原始变量筛选、普通Logistic | L03_Feature_Selection_Logistic.R |
| 完整训练内筛选/调参的外层OOF | L04_Internal_Validation.R |
| 共享特征的RF/XGBoost/SVM与SHAP | L05_ML_Comparison_SHAP.R |
| 第5课集中纠错、Kappa冻结与留出对照 | L06_Data_Audit_T0_Correction.R |
| 单变量整体LRT与AIC机制展示 | Teacher_Selection_Demonstrations.R |
| 冻结系数列线图及验证 | Export_Classroom_Artifacts.R、Validate_Review_Run.R、Check_Separation.py |
| Python完整统计主链快速展示 | Export_Python_Raw.R、Python_Statistical_Workflow.py |
Python演示保留原始缺失与固定成员,在各训练范围独立筛查、插补和选择lambda.min,再按原始变量拟合普通Logistic,训练OOF最大Kappa阈值冻结后用于测试。使用scikit-learn 1.9的SAGA,与R glmnet内层实现不同,不要求数值完全一致;R维护正式四模型比较。完整脚本课前预跑,最后一课仅快速展示数据→描述→筛选→拟合→评价,课后可依据代码与浓缩讲义复现。
All111是异常教学反例;Corrected执行已确认的时间、稀疏/零格、无变异和极低观测比例筛查。旧版T0_102不是最终纠正版。不要用已全训练插补的矩阵做CV,不从测试选变量、调参或选阈值。具体统计边界见教学契约。
通用技术Demo与原有代码片段
以下Demo_R_Project及其数值属于独立技术示范,保留作为片段查阅;本节默认值不覆盖上面的主案例配置。
本章解决什么问题:第 4 章用完整内部验证回答了”这套 Logistic 建模流程大概有多好”,本章回答紧随其后的三个问题——换成机器学习模型会不会更好(在同一 outer fold 骨架上公平比较 Logistic、随机森林、XGBoost、支持向量机);最终模型定哪一个(按预先写死的规则选模并锁定);它的最终成绩是多少(锁定后在封存的 Holdout Test 上只评价一次,之后不返回选优)。全章纪律只有六个字:先锁后测。
本章定位: 精讲 Demo 脚本 Demo_R_Project/R/05_ml_compare_final_test.R——四个模型的统一接口、折内重学与内层调参、选模规则、锁定产物落盘、测试集一次性评价,以及锁定模型的 SHAP(SHapley Additive exPlanations)解释。机器学习迁移与最终评价的概念框架见讲义 Book1 第5章,评价指标(ROC/AUC、校准、Brier、DCA)的读法见 Book1 第4章;本章只给代码与产物层面的最小提示。
学习目标: 读完本章,你应该能够:(1)说出四个模型如何在同一批 fold 上做到公平比较(同成员、同折、同折内变量集);(2)指出脚本里”内层 CV(cross-validation,交叉验证)调参与 outer 评价分离”的具体行;(3)复述选模规则并解释简约边际(parsimony margin)的作用;(4)列出锁定三件套(model_selection_record.csv / locked_model_config.csv / locked_model.rds)各自记录什么;(5)说明阈值为什么只能在训练 OOF(out-of-fold,折外)预测上定;(6)如实解读一次小样本测试的全部指标,包括不如内部验证好看的结果;(7)引用 SHAP 结果时写清模型、解释样本、背景数据与输出尺度四要素。
注记技术演示,不是第三个正式教学 Case
本章全部统计结果来自本书配套技术 Demo(Demo_R_Project/,数据 MASS::Pima.tr2,R 4.5.2 实跑冻结)。Demo 只用于演示代码、产物与核对方法;正式教学数据仍只有两套——Myocardial Infarction Complication(直播主案例)与 Early Stage Diabetes Risk Prediction(Mini Project),见 ../../04_Cases/。Demo 的数字不进任何正式案例口径。
什么时候用
当你的流程里出现以下任一环节,就用本章的骨架:
- 需要在 Logistic 之外比较随机森林(random forest,RF)、XGBoost(extreme gradient boosting)、支持向量机(support vector machine,SVM)等模型,且比较必须公平(同成员、同折、同预处理口径);
- 流程含调参,需要把调入关进内层 CV,与 outer 评价严格分离;
- 建模开发接近尾声,需要选模、锁定、冻结阈值,然后给留出测试集唯一的、一次性的评价;
- 需要给锁定模型一份写清口径的机器解释(SHAP)。
只有单一候选模型、无参可调时不需要本章——第 4 章的内部验证加一次锁定测试即可;只要流程里出现”用数据选超参数”或”在多个模型间挑一个”,比较与锁定纪律就不能省。
输入与输出
输入(全部来自 Demo 前几步,测试集此时仍封存):
Demo_R_Project/data/derived/cohort_clean.csv:清理后的分析队列(n = 300,事件 106);Demo_R_Project/results/tables/split_manifest.csv:Training(211 例,事件 75)/ Holdout Test(89 例,事件 31)成员清单;Demo_R_Project/results/tables/fold_manifest.csv:训练集 5 折 outer CV 成员清单(与第 4 章同一批折);Demo_R_Project/results/models/lasso_mainline.rds:第 3 章主线在全训练集上的 LASSO 入选变量与lambda.min;Demo_R_Project/config/config.R:单一配置源——seed、折数、调参网格、阈值规则、简约边际parsimony_margin = 0.005。
输出(按落盘顺序分组):
| 阶段 | 产物 | 说明 |
|---|---|---|
| 比较 | results/tables/ml_cv_comparison.csv |
逐折逐模型 AUC/Brier 与内层 CV 选出的超参数 |
| 比较 | results/tables/ml_cv_comparison_summary.csv |
各模型合并 OOF 的 AUC(95% CI)与 Brier |
| 比较 | results/figures/ml_cv_comparison.png |
逐折 AUC 箱线图 |
| 锁定 | results/models/model_selection_record.csv |
选模记录:谁被选中、规则、理由、日期 |
| 锁定 | results/models/locked_model_config.csv |
锁定配置:变量、预处理参数、超参数、阈值与来源 |
| 锁定 | results/models/locked_model.rds |
锁定模型对象(含预处理器与阈值) |
| 测试 | results/tables/final_test_predictions.csv / final_test_metrics.csv |
测试集逐例预测与指标汇总 |
| 测试 | results/figures/test_roc.png / test_calibration.png / test_dca.png |
测试集 ROC、校准、DCA(decision curve analysis,决策曲线分析)三图 |
| 解释 | results/tables/shap_run_info.csv / results/figures/shap_summary.png |
SHAP 运行口径与蜂群汇总图 |
脚本与产物
唯一脚本:Demo_R_Project/R/05_ml_compare_final_test.R(可经 Demo_R_Project/run_all.R 统一调度)。参考运行时长约 11.5 秒(R 4.5.2,2026-09-18 实跑,ranger 0.17.0 / xgboost 3.1.2.1 / e1071 1.7.17 / kernelshap 0.9.1)。
脚本执行顺序与本章叙述顺序一致,也是本章要求你记住的顺序:
让 Agent 执行
本章任务的标准说法:原样运行第 5 步脚本,核对锁定三件套的落盘顺序与全部测试指标。完整 Prompt 模板见 prompts/05_ML比较与最终测试.md,可直接复制给 Coding Agent。
让 Agent 运行 Demo 第 5 步脚本并核对比较、锁定与测试产物。替换方括号后整体复制发送。
【背景】这是一个教学技术 Demo(MASS::Pima.tr2),前几步已产出 cohort_clean.csv、
split/fold manifest 与 Logistic 内部验证结果,Holdout Test 封存中。
【当前任务】在 Demo_R_Project 项目根目录运行:Rscript R/05_ml_compare_final_test.R,
完成 4 模型比较、选模、锁定与 Holdout Test 一次性评价。
【约束】1. 原样运行,不改代码、种子与调参网格;
2. 锁定产物(model_selection_record.csv / locked_model_config.csv / locked_model.rds)
必须先于任何测试集读取与评价落盘;
3. 测试集只评价一次;测试后不得返回重选模型、重调超参数或改阈值;
4. 结果数字以实际运行输出为准,不得凭记忆填写。
【输出要求】报告产物路径:ml_cv_comparison.csv、ml_cv_comparison_summary.csv、
model_selection_record.csv、locked_model_config.csv、locked_model.rds、
final_test_predictions.csv、final_test_metrics.csv、shap_run_info.csv,
以及 ml_cv_comparison.png、shap_summary.png、test_roc.png、test_calibration.png、test_dca.png。
【验收/暂停条件】逐项报告:各模型 OOF AUC(95%CI)与 Brier、选中模型与选择理由、
锁定阈值与来源、测试 AUC(95%CI)/Brier/校准截距与斜率/混淆矩阵。
若锁定产物晚于测试评价落盘、折内未重学预处理与 LASSO、或任何数字缺失,
停下来报告证据,不要自行改代码。
Agent 协作的三条纪律:(1)它若提议”先把测试集也跑一遍看看哪个模型好”,拒绝并指出红线——测试集不参选;(2)它若在测试后提议”换个阈值灵敏度更高”,拒绝并记入课题日志——阈值已在训练 OOF 上锁定;(3)任何数字以脚本落盘的 CSV 为准,不接受 Agent 凭记忆复述。与 Agent 分工的通用方法见工具手册 Book2 第3章 与 Book2 第5章。
核心实现
完整实现只在 Demo_R_Project/R/05_ml_compare_final_test.R 维护;以下摘录五段关键结构。
四个模型,一个接口
四个模型共用同一对 fit_model() / predict_prob() 接口,输入统一为”该折训练子集 + 该折 LASSO 入选变量 + 该折调出的超参数”。摘录 Logistic 与 RF 两个分支:
05_ml_compare_final_test.R(摘录 1:统一建模接口,Logistic 与 RF 分支)
fit_model <- function(type, train_imp, vars, hyper, seed_offset) {
  fml_y  <- stats::as.formula(paste("y ~", paste(vars, collapse = " + ")))
  fml_yc <- stats::as.formula(paste("y_class ~", paste(vars, collapse = " + ")))
  if (type == "logistic") {
    fit <- stats::glm(fml_y, data = train_imp, family = stats::binomial)
    if (!fit$converged) stop("logistic fit did not converge in ML pipeline.")
    return(fit)
  }
  if (type == "rf") {
    # 防泄漏关键:dependent.variable.name 接口会把 data 中其余所有列当预测变量,
    # 必须只传入入选变量 + 结局列,否则 y/type/row_id 会进入森林。
    fit <- ranger::ranger(dependent.variable.name = "y_class",
                          data = train_imp[, c(vars, "y_class")],
                          probability = TRUE, mtry = hyper$mtry,
                          min.node.size = hyper$min.node.size,
                          num.trees = config$rf_num_trees,
                          seed = config$seed + seed_offset)
    if (!all(fit$forest$independent.variable.names %in% vars))
      stop("RF forest uses variables outside the fold-selected set; aborting.")
    return(fit)
RF 分支里有两处值得带走的工程细节:data = train_imp[, c(vars, "y_class")] 只传入选变量与结局列,防止 y、row_id 等列被当成预测变量混进森林;紧随其后的 stop() 断言把”森林只用了入选变量”从假设变成运行时检查。XGBoost 与 SVM 分支见脚本(xgb.train 用设计矩阵接口,e1071::svm 开 probability = TRUE),接口签名完全一致。
折内重学,内层调参
outer fold 主循环是防泄漏的核心:每一折内重新学习预处理、重新做 LASSO(least absolute shrinkage and selection operator)得到该折变量集,同一折内 4 个模型共享这套变量,RF/XGBoost/SVM 的超参数在该折训练子集内用内层 5 折 CV 按 AUC 选出——调参永远接触不到 outer 留出折:
05_ml_compare_final_test.R(摘录 2:outer fold 主循环核心)
  prep_f <- fit_preprocessor(sub_df)
  sub_imp <- apply_preprocessor(sub_df, prep_f)
  ass_imp <- apply_preprocessor(ass_df, prep_f)
  design_f <- build_design(sub_imp, config$predictors)
  set.seed(config$seed + f)
  cvf <- glmnet::cv.glmnet(design_f$X, sub_imp$y, family = "binomial",
                           nfolds = config$inner_folds)
  cf <- as.matrix(stats::coef(cvf, s = config$lasso_lambda))
  terms_f <- setdiff(rownames(cf)[abs(as.numeric(cf[, 1])) > .Machine$double.eps],
                     "(Intercept)")
  if (length(terms_f) == 0L) stop("Fold ", f, ": LASSO empty selection; aborting.")
  vars_f <- map_terms_to_variables(terms_f, design_f$col_var)
  for (mt in model_types) {
    hyper_mt <- if (mt == "logistic") NULL else tune_model(mt, sub_imp, vars_f, f)$hyper
    fit_mt <- fit_model(mt, sub_imp, vars_f, hyper_mt, f * 100)
p_mt <- predict_prob(mt, fit_mt, ass_imp, vars_f)三个核对点:fit_preprocessor(sub_df) 的输入是该折训练子集而非全训练集;tune_model(mt, sub_imp, ...) 的内层 CV 只在 sub_imp 内进行;ass_imp(留出折)只被 predict_prob 评价,不参与任何”学”。逐折调出的超参数全部记录在 ml_cv_comparison.csv 的 hyperparameters 列(本次运行 RF 各折均为 mtry=2; min.node.size=10,XGBoost 均为 eta=0.05; max_depth=2,SVM 除第 2 折用默认 scale 外均为 cost=1; gamma=0.1)——调参留痕,事后可审计。
选模规则:先定规则,后看结果
规则在看结果之前就已写死在 config 与脚本里:OOF AUC 最高者中选;若复杂模型领先 Logistic 不足 parsimony_margin = 0.005,按简约原则仍选 Logistic——可解释性相当的模型里,简单者优先:
05_ml_compare_final_test.R(摘录 3:选模规则)
# ---- 选模:OOF AUC 最优;若复杂模型领先 Logistic 不足 parsimony_margin 则取简约 --
ord <- order(ml_summary$oof_auc, decreasing = TRUE)
top <- ml_summary$model[ord[1]]
logi_auc <- ml_summary$oof_auc[ml_summary$model == "Logistic"]
top_auc <- ml_summary$oof_auc[ord[1]]
if (top != "Logistic" && (top_auc - logi_auc) < config$parsimony_margin) {
  selected_model <- "Logistic"
选出的模型、规则原文与理由一并写入 model_selection_record.csv。这条纪律与第 4 章”评价标准先于数字”同源:规则一旦在看到结果之后写,它就不再是规则,而是追认。
阈值:在训练 OOF 上锁定
分类阈值不在测试集上试,也不拍脑袋取 0.5:脚本用锁定模型在训练集上的 5 折 OOF 预测画 ROC(receiver operating characteristic)曲线,按 config 的 threshold_rule = "youden"(Youden 指数)取最优点,并断言阈值落在 (0, 1) 内:
05_ml_compare_final_test.R(摘录 4:阈值锁定)
roc_lock <- pROC::roc(train_imp_full$y, lock_oof, quiet = TRUE)
co <- pROC::coords(roc_lock, x = "best", best.method = config$threshold_rule,
                   ret = c("threshold", "sensitivity", "specificity"),
                   transpose = FALSE)
co <- as.data.frame(co)
co <- co[order(-(co$sensitivity + co$specificity), -co$threshold), ]
locked_threshold <- as.numeric(co$threshold[1])
if (!is.finite(locked_threshold) || locked_threshold <= 0 || locked_threshold >= 1)
  stop("Locked threshold is not a finite value in (0,1); aborting.")
锁定阈值 0.2497——低于训练集事件率(75/211 ≈ 0.36),意味着这是一个偏”宁可多报”的工作点,测试集上的灵敏度/特异度格局(见下文)正由此而来。
先锁后测:代码顺序即纪律
本章最重要的一段不是统计,而是行序:锁定三件套落盘、日志写下 MODEL LOCKED 之后,脚本才第一次读取测试集成员做评价:
05_ml_compare_final_test.R(摘录 5:锁定落盘在前,测试评价在后)
saveRDS(list(model_type = selected_type, model = locked_fit, prep = prep_full,
             vars = locked_vars, hyper = locked_hyper, threshold = locked_threshold,
             threshold_rule = config$threshold_rule, formula_text = paste(locked_vars, collapse = " + ")),
        file.path(ROOT, "results", "models", "locked_model.rds"))
register_artifact("results/models/locked_model.rds", "ch05", "model",
                  "R/05_ml_compare_final_test.R", "training set",
                  "training set", "locked model object; written BEFORE any test-set access")
log_msg("05 MODEL LOCKED (", selected_model, "). Test-set evaluation begins now; no re-selection afterwards.")

# ======================== Holdout Test 一次性评价 ===============================
test_df <- as.data.frame(cohort[cohort$row_id %in% test_ids, ])
test_imp <- apply_preprocessor(test_df, prep_full)
p_test <- predict_prob(selected_type, locked_fit, test_imp, locked_vars)
artifact 注册表里 written BEFORE any test-set access 不是注释,是每笔锁定产物登记在案的口径说明;locked_model_config.csv 的 lock_timestamp(2026-09-18 10:37:37)与运行日志提供了可审计的时间证据。测试集预处理用的是全训练集学好的 prep_full,测试集本身不学任何东西。
SHAP:把”解释”也写清口径
SHAP 解释的是锁定后的 Logistic 模型,解释样本与背景(参考)数据都是训练集(各 211 例);Logistic 的 SHAP 值输出在 log-odds(logit 线性预测子)尺度上,而非概率尺度:
05_ml_compare_final_test.R(摘录 6:SHAP 口径与计算)
# ---- SHAP:解释锁定模型(样本=训练集,背景=训练集;尺度按模型类型记录)-----------
X_explain <- train_imp_full[, locked_vars, drop = FALSE]
shap_scale <- if (selected_type == "logistic") "log-odds" else "probability"
pred_fun_shap <- switch(selected_type,
  logistic = function(obj, newdata)
    stats::predict(obj, newdata = as.data.frame(newdata), type = "link"),
  rf = function(obj, newdata)
    stats::predict(obj, data = as.data.frame(newdata))$predictions[, config$positive_class],
  xgb = function(obj, newdata)
    stats::predict(obj, xgboost::xgb.DMatrix(build_design(as.data.frame(newdata), locked_vars)$X)),
  svm = function(obj, newdata)
    attr(stats::predict(obj, newdata = as.data.frame(newdata), probability = TRUE),
         "probabilities")[, config$positive_class])
ks <- kernelshap::kernelshap(locked_fit, X = X_explain, bg_X = X_explain,
                             pred_fun = pred_fun_shap, verbose = FALSE)
sv <- shapviz::shapviz(ks)四要素(模型、解释样本、背景数据、输出尺度)连同方法(kernelshap::kernelshap + shapviz,版本 0.9.1 / 0.10.3)落盘为 shap_run_info.csv——引用任何 SHAP 结论前先把这四要素写上,缺一个,解释就没有口径。
实际运行结果
以下两段片段由 Demo 脚本自动生成并冻结(2026-09-18),正文不手抄大表。
机器学习比较与选模
机器学习比较与选模 · 本片段由 Demo 脚本自动生成,供教材引用
4 个模型在同一 outer fold 骨架内比较(折内重学预处理与 LASSO 变量,内层 5 折 CV 调参):
| 模型 | OOF AUC (95% CI, DeLong) | OOF Brier | 备注 |
|---|---|---|---|
| Logistic | 0.844 (0.792-0.895) | 0.1600 | 选中 |
| RandomForest | 0.806 (0.745-0.867) | 0.1682 | |
| XGBoost | 0.786 (0.719-0.852) | 0.1813 | |
| SVM | 0.805 (0.744-0.867) | 0.1700 |
- 选中模型:Logistic。
- 选择理由:Logistic selected: it achieved the highest OOF AUC 0.8437 (95% CI 0.7921-0.8954, DeLong) among all compared models, and is also the most interpretable.
- 锁定阈值:0.2497(规则:youden;来源:锁定模型在训练集上的 CV 折外预测)。
- 锁定超参数:none;锁定变量:
npreg、glu、bp、bmi、ped、age、bmi_cat。 - 纪律:锁定产物(model_selection_record / locked_model_config / locked_model.rds)全部先于 Holdout Test 评价落盘;测试后不返回重选。
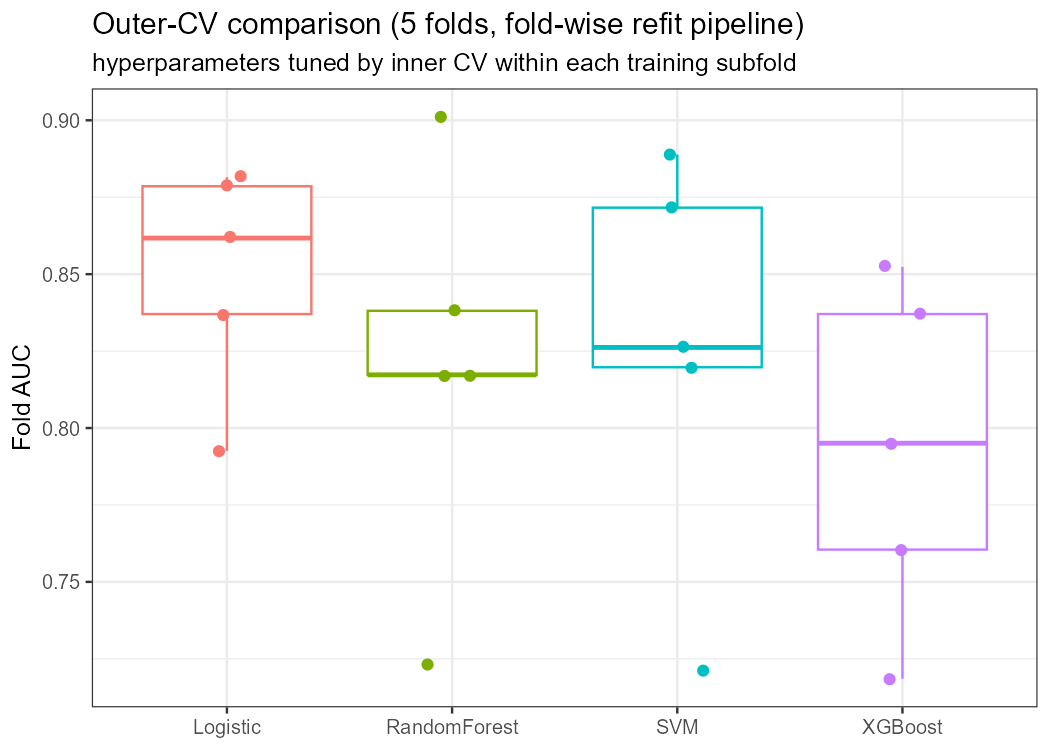
逐折波动见 图 5.1:四个模型各 5 个折 AUC,Logistic 逐折 0.793–0.881,RF 0.723–0.901,XGBoost 0.719–0.852,SVM 0.721–0.889。RF 在第 5 折单折最高(0.901),但逐折值只看波动、不作选模依据——选模用的是 211 个 OOF 预测合并后的整体表现。
Holdout Test 一次性评价
Holdout Test 最终评价 · 本片段由 Demo 脚本自动生成,供教材引用
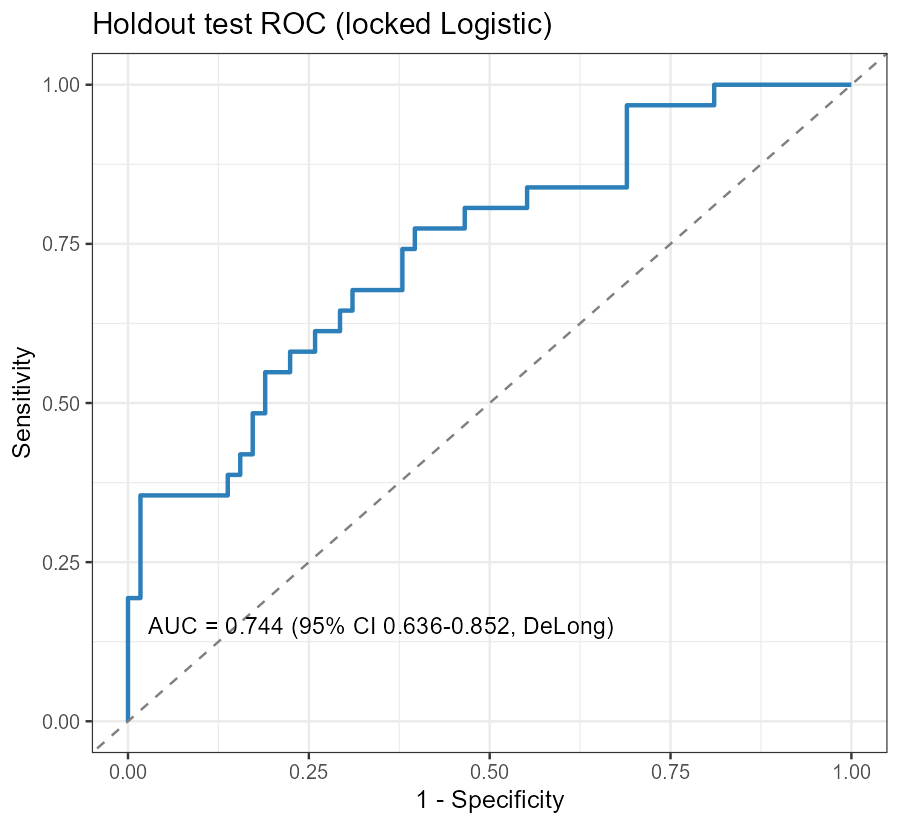
锁定模型:Logistic;测试集 n = 89(事件 31),全程未参与任何学习,仅评价一次。
| 指标 | 值 |
|---|---|
| AUC (95% CI, DeLong) | 0.744 (0.636-0.852) |
| Brier | 0.1888 |
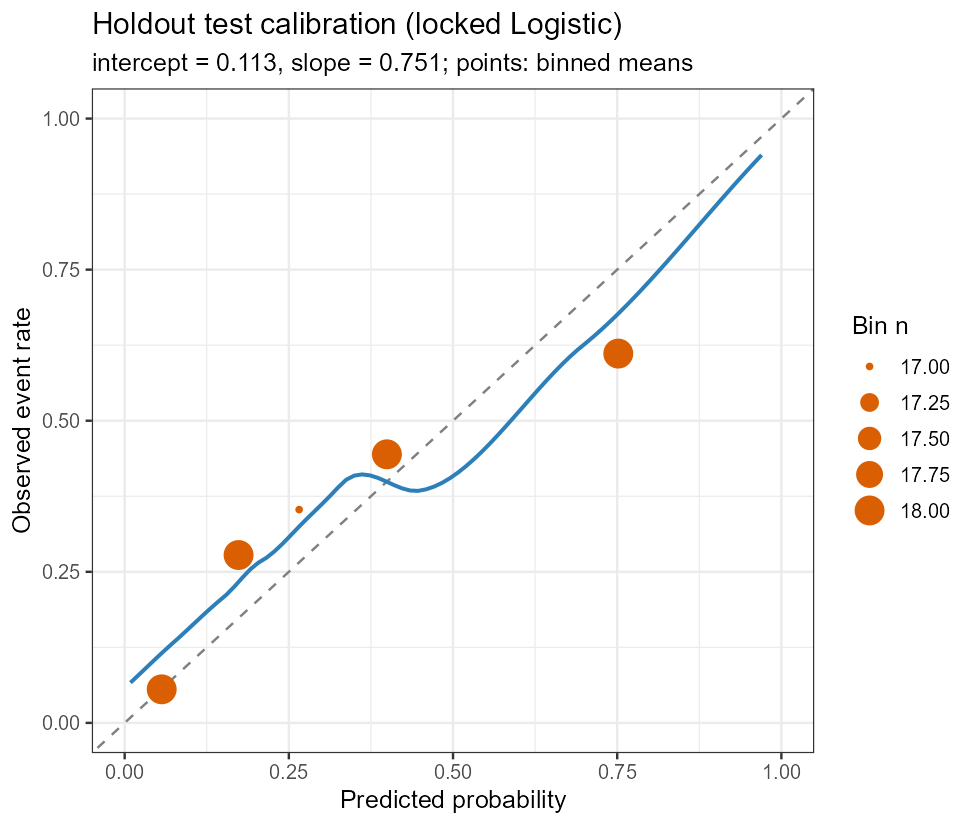
| 校准 intercept / slope | 0.113 / 0.751 |
| 阈值(锁定) | 0.2497 |
| Sensitivity | 0.774 |
| Specificity | 0.586 |
| Accuracy | 0.652 |
| TP / FP / TN / FN | 24 / 24 / 34 / 7 |
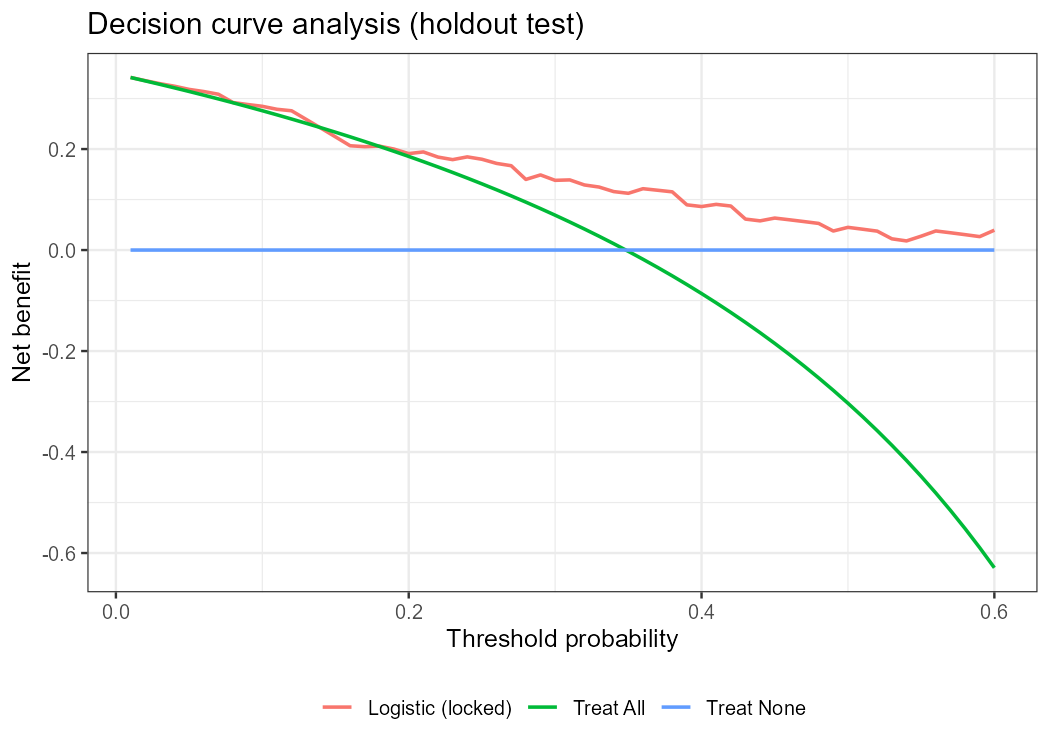
图 5.2、图 5.3 与 图 5.4 三张图与指标表同源,全部长自 89 例测试预测:
SHAP 汇总
图 5.5 是锁定模型的 SHAP 蜂群图:每个点是一名训练样本在某个变量上的 SHAP 值(log-odds 尺度),正值把预测推向事件、负值推离事件。
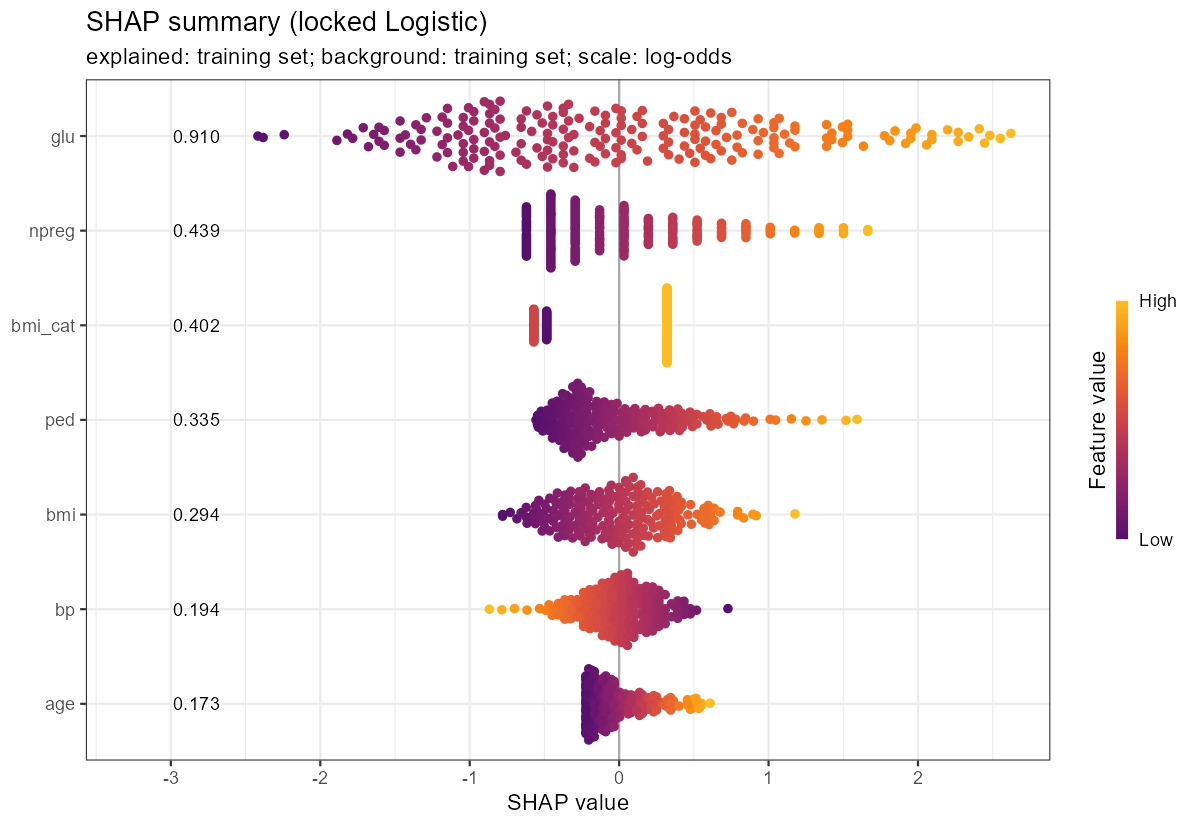
注记SHAP 四要素(引自 shap_run_info.csv)
模型:Logistic(logistic);解释样本:训练集(n = 211);背景/参考数据:训练集(n = 211);输出尺度:log-odds。方法:kernelshap::kernelshap + shapviz(kernelshap 0.9.1,shapviz 0.10.3)。锁定模型是线性的,SHAP 排序与系数方向一致——本章用它演示的是口径记录流程,不是发现新机制;变量排序的临床解释属于正式案例的任务,Demo 数据不做临床外推。
结果怎么读
比较结果:Logistic 赢得干净
OOF AUC:Logistic 0.844(95% CI 0.792–0.895,DeLong)> RF 0.806 ≈ SVM 0.805 > XGBoost 0.786;Brier 同样以 Logistic 最低(0.1600)。三个复杂模型没有任何一个领先 Logistic,简约边际规则甚至无需触发——Logistic 同时是”最准”与”最可解释”的选择。这个结果本身是教学点:样本量小、信号以线性可加为主时,复杂模型没有免费午餐;换数据结论可能不同,但”用 OOF 说话、按预设规则选”的流程不变。
测试结果:如实报告,不修饰
测试 AUC 0.744(0.636–0.852)低于训练 OOF 的 0.844,点估计甚至落在 OOF 区间下限之外。读法三层:
- 样本小,区间宽:89 例、31 个事件撑起的 AUC 区间宽达 0.22;测试区间(0.636–0.852)与 OOF 区间(0.792–0.895)仍有重叠,单次小样本抽样的波动完全能产生这种差距,不构成”流程失效”的证据;
- 方向是提醒不是意外:OOF 估计的是”流程在训练人群内的期望表现”,锁定模型放到一次未参与学习的抽样子集上,点估计下移是常态;校准斜率 0.751 < 1(预测偏分散)与 Brier 从 0.1600 升至 0.1888 同向印证温和过拟合;
- 纪律不变:看到 0.744 之后什么都不改——不改模型、不调阈值、不重新划分。测试的用途是记录最终表现,不是改进它;任何”看完测试再优化”的动作都会把测试集变成新的训练集。
锁定阈值 0.2497 下的混淆矩阵(TP 24 / FP 24 / TN 34 / FN 7)给出灵敏度 0.774、特异度 0.586、准确度 0.652——低阈值换来较高灵敏度、牺牲特异度,与锁定时的 Youden 工作点一致;这个权衡在锁定时就定了,测试只是把它端出来。校准截距 0.113 接近 0,提示整体概率无系统性高估或低估。
SHAP 怎么读
蜂群图按变量平均 |SHAP| 排序,与 Logistic 系数的相对大小一致;log-odds 尺度意味着 SHAP 值可以直接加减到线性预测子上。三不读:不把 log-odds 尺度的数值当概率读;不把训练集上的解释外推到其他人群;不凭一张图宣称因果方向——SHAP 描述的是”模型用了什么”,不是”世界就是这样”。
验收清单
| 核对项 | 参考值(Demo,2026-09-18 实跑) | 不对时怀疑什么 |
|---|---|---|
| 各模型 OOF 行数 | n_oof = 211(每名训练成员恰好一次) |
折成员用错;测试集混入 |
| 各模型 OOF AUC | Logistic 0.844 / RF 0.806 / XGBoost 0.786 / SVM 0.805 | 折内未重学预处理;调参泄漏到 outer 折 |
| 选中模型与规则 | Logistic;规则含”complex model must beat Logistic by >= 0.005 AUC” | 看完结果临时改规则 |
| 锁定配置 | 变量 npreg–bmi_cat 共 7 个;超参数 none;阈值 0.2497(youden,训练 OOF) |
阈值来自测试集;变量与第 3 章主线不一致 |
| 锁定时序 | lock_timestamp 2026-09-18 10:37:37,日志 MODEL LOCKED 在测试评价之前 |
先测后锁(红线) |
| 测试指标 | AUC 0.744(0.636–0.852);Brier 0.1888;sens 0.774 / spec 0.586 / acc 0.652;TP/FP/TN/FN = 24/24/34/7 | 测试集被评价第二次;指标换了口径 |
| SHAP 口径 | shap_run_info.csv 四要素齐全(模型/样本/背景/尺度) |
尺度错读(log-odds 当概率) |
| 五张图 | 图题口径与上表一致;数字与 CSV 同源 | 图用错预测来源(如表观预测) |
常见错误
- 用测试集帮选模型。 症状:“跑完测试发现 RF 的测试 AUC 更高,换 RF”。测试 AUC 高不再是证据——测试集一旦参选,它就失去了最终评价的资格。处理:选模只看训练 OOF。
- 测试后返回调阈值或重选。 症状:“0.2497 在测试集上特异度偏低,调到 0.35 试试”。处理:阈值在训练 OOF 上锁定;测试后任何调整都属于下一轮研究,需要新的封存测试集。
- 调参泄漏到 outer 折。 症状:内层 CV 在含留出折的数据上做,或所有折共用一套超参数。处理:检查
tune_model的输入是不是该折训练子集sub_imp。 - 把随机 Holdout 叫外部验证。 症状:报告里写”external validation AUC 0.744”。处理:同一人群随机留出的测试是内部评价的最后一环,不是外部验证;外部验证要求独立时间、地点或人群。
- 把 OOF 当最终成绩。 症状:摘要写”模型 AUC 0.844”。处理:0.844 是训练集内部验证口径;最终成绩是锁定后的一次测试 0.744,两者都必须带口径标签引用。
- 只报点估计不报区间与样本量。 症状:“测试 AUC 0.74”孤零零出现。处理:89 例、31 事件的 AUC 必须带 95% CI(0.636–0.852)与 n 一起报,小样本点估计的波动幅度本身就是信息。
- SHAP 不写口径就当全局结论。 症状:贴一张蜂群图说”X 变量最重要”。处理:先写模型、解释样本、背景数据、输出尺度四要素,再开口;log-odds 尺度的正负号只表示推向/推离事件。
- 把整表数据框喂给 RF。 症状:森林的预测变量里出现
row_id或结局列,OOF 好得离谱。处理:只传入c(vars, "y_class")列子集,并保留脚本中的变量集合断言。
复用时替换什么
搬到自己的数据(如正式案例)时,替换以下内容,骨架不变:
- 数据与结局:
cohort_clean.csv、config 中的outcome/positive_class/predictors;派生变量规则(如bmi_cat这样的技术演示派生变量)换成自己方案里预先定义的编码; - 模型清单与网格:
model_types向量与config$rf_grid/xgb_grid/svm_grid——网格可以大,但调参必须留在内层 CV; - 选模规则:
parsimony_margin的取值或整条规则——但必须在看结果前写死并记录; - 阈值规则:
threshold_rule(如从 youden 改为灵敏度优先的约束规则),来源仍是训练 OOF; - 预处理函数:
fit_preprocessor()/apply_preprocessor()的缺失处理与标准化规则。
不许替换的纪律:先锁后测的行序;折内重学预处理与变量筛选;内层调参与 outer 评价分离;阈值来自训练 OOF;测试只评价一次、不返回选优。这五条与数据无关,是流程的地基。
相关资源
- 概念讲义:机器学习迁移与最终评价见 Book1 第5章;ROC/AUC、校准、Brier、DCA 的读法见 Book1 第4章;
- Agent 协作:任务交托与环境纪律见 Book2 第3章、Book2 第5章;
- 本章 Prompt 模板:
prompts/05_ML比较与最终测试.md; - Demo 项目说明:
Demo_R_Project/README.md;完整实现:Demo_R_Project/R/05_ml_compare_final_test.R; - 正式教学案例(直播主案例与 Mini Project):04_Cases 案例运行指南;
- 本书相邻章节:第 3 章(LASSO → Logistic refit → Nomogram,提供本章锁定的主线变量集)、第 4 章(完整内部验证,与本章共用同一批 fold_manifest)、第 6 章(Python 迁移,读取本章锁定前的成员与 fold 契约)。