flowchart TD
A[训练集 211 例] --> B[5 折 outer CV<br/>fold_manifest.csv]
B --> C{轮流取 1 折作评估}
C --> D[其余 4 折内重学:<br/>插补/编码/标准化<br/>→ LASSO → 映射 → glm refit]
D --> E[评估折只接受<br/>折内参数变换与预测]
E --> C
C --> F[拼齐 211 个 OOF 预测<br/>每人恰好一次]
F --> G[统一计算:<br/>AUC/Brier/校准/DCA]
第4章 完整内部验证与评价图
现行主案例执行入口(2026-09-19)
Myocardial_Infarction_Complications的唯一执行根位于仓库 04_Cases/Myocardial_Infarction_Complications/,参数由analysis_config.R维护。按案例运行指南执行,不能复制本章技术Demo的变量、折数或数值替代主案例。
| 任务 | 主案例脚本 |
|---|---|
| 读取与描述、固定成员 | L01_Read_Check_Demo.R、L02_Data_Preparation.R |
| LASSO lambda.min按原始变量筛选、普通Logistic | L03_Feature_Selection_Logistic.R |
| 完整训练内筛选/调参的外层OOF | L04_Internal_Validation.R |
| 共享特征的RF/XGBoost/SVM与SHAP | L05_ML_Comparison_SHAP.R |
| 第5课集中纠错、Kappa冻结与留出对照 | L06_Data_Audit_T0_Correction.R |
| 单变量整体LRT与AIC机制展示 | Teacher_Selection_Demonstrations.R |
| 冻结系数列线图及验证 | Export_Classroom_Artifacts.R、Validate_Review_Run.R、Check_Separation.py |
| Python完整统计主链快速展示 | Export_Python_Raw.R、Python_Statistical_Workflow.py |
Python演示保留原始缺失与固定成员,在各训练范围独立筛查、插补和选择lambda.min,再按原始变量拟合普通Logistic,训练OOF最大Kappa阈值冻结后用于测试。使用scikit-learn 1.9的SAGA,与R glmnet内层实现不同,不要求数值完全一致;R维护正式四模型比较。完整脚本课前预跑,最后一课仅快速展示数据→描述→筛选→拟合→评价,课后可依据代码与浓缩讲义复现。
All111是异常教学反例;Corrected执行已确认的时间、稀疏/零格、无变异和极低观测比例筛查。旧版T0_102不是最终纠正版。不要用已全训练插补的矩阵做CV,不从测试选变量、调参或选阈值。具体统计边界见教学契约。
通用技术Demo与原有代码片段
以下Demo_R_Project及其数值属于独立技术示范,保留作为片段查阅;本节默认值不覆盖上面的主案例配置。
本章解决什么问题:第 3 章交出的是一个在全训练集上拟合完成的候选模型,本章回答它最要紧的问题——这套开发流程放到没见过的同类患者身上,大概还剩多少分?答案不能靠在训练集上再算一遍指标得到(那叫表观,必然偏乐观),只能靠完整流程的内部验证:把训练集分成若干折,每一折内把插补、编码、标准化、LASSO 筛选、Logistic 重拟合全部重新做一遍,用折外预测计算 ROC、校准、Brier 与 DCA。概念原理见讲义第 4 章 模型评价与内部验证,本章重心是:防泄漏的代码结构长什么样、三张评价图从哪份数据长出来、产物拿什么数字核对。
注记Demo 的定位
本章全部数字与图来自 Book 3 配套技术 Demo(Demo_R_Project/,数据 MASS::Pima.tr2)的真实运行结果,用于演示代码、产物与核对方法。它不是第三个正式教学 Case:正式教学数据只有 Myocardial Infarction Complication(直播主案例)与 Early Stage Diabetes Risk Prediction(Mini Project),见 ../../04_Cases/。Demo 的结论不得外推为临床结论。
什么时候用
本章方法适用于以下节点:
- 建模流程(含变量筛选与预处理规则)已经定型、接触留出测试集(Holdout Test)之前,需要一份对”同类新患者”的诚实性能估计;
- 需要区分度、校准、综合误差、临床净获益四个维度的证据,即 ROC(Receiver Operating Characteristic,受试者工作特征曲线)/ AUC(Area Under the Curve,曲线下面积)、Calibration(校准)、Brier 分数(Brier Score)、DCA(Decision Curve Analysis,决策曲线分析)三图一组;
- 需要证明”筛选是在折内独立完成的”——折级审计是审稿与答辩中最容易被追问的证据。
它不适用于两件事:一是替代外部验证(External Validation,指在另一时间、另一机构、另一人群的数据上评价),本章的折外估计只是内部验证;二是反复试错的调参依据——OOF 指标看一眼、记录、用于第 5 章的选模决策,不允许拿着它来回改流程再重算。
输入与输出
输入(均为前序脚本已落盘的产物,本章脚本只读):
| 输入 | 路径 | 来自 |
|---|---|---|
| 清理后分析队列 | Demo_R_Project/data/derived/cohort_clean.csv |
第 2 章脚本 |
| 训练/测试成员清单 | Demo_R_Project/results/tables/split_manifest.csv |
第 2 章脚本 |
| 5 折成员清单 | Demo_R_Project/results/tables/fold_manifest.csv |
第 2 章脚本 |
| 分析参数 | Demo_R_Project/config/config.R |
单一配置源 |
配置中与本章直接相关的参数:outer_folds = 5、inner_folds = 5、lasso_lambda = "lambda.min"、dca_thresholds = 0.01–0.60。seed、折数、结局编码只允许从 config.R 读取,脚本内不维护第二份。
输出(全部写入 Demo_R_Project/results/,并登记进 artifact_manifest.csv):
| 产物 | 内容 |
|---|---|
tables/cv_predictions_logistic.csv |
折外预测主表:row_id、所属折、真实结局、OOF 预测概率 |
tables/cv_selected_variables_by_fold.csv |
每折独立筛出的原始变量(折内重选的直接证据) |
tables/cv_metrics_logistic.csv |
OOF 指标:AUC 及 DeLong 区间、Brier、校准截距/斜率,含方法口径列 |
tables/cv_pipeline_audit.csv |
折级审计:各折样本量、事件数、入选变量、lambda.min、收敛状态 |
figures/roc_cv.png / calibration_cv.png / dca_cv.png |
ROC、校准、DCA 三张评价图 |
book_fragments/ch04_cv_summary.md |
本章引用的结果片段(脚本自动生成) |
脚本与产物
完整实现只维护在一个地方:Demo_R_Project/R/04_internal_validation.R。它的结构是:
- 读取与核对:载入队列与两份 manifest,确认 DCA 阈值落在 (0,1);
- 折内独立流水线:
run_fold_logistic()对 5 个 outer fold 逐一执行完整开发流程(见核心实现); - OOF 合并与断言:拼齐折外预测,断言恰好覆盖训练集每人一次;
- 指标与落盘:AUC(DeLong 区间)、Brier、校准截距/斜率,写四张表;
- 三图与教材片段:ROC、校准、DCA 图,自动生成
ch04_cv_summary.md。
脚本中任何一步命中暂停条件(某折结局单类、LASSO 空选、Logistic 不收敛或完全分离、OOF 覆盖不完整)都直接中止并报告,不做静默换方法。配套的可复制任务 Prompt 见 prompts/04_完整内部验证.md。
让 Agent 执行
本章脚本依赖第 1–3 章产物,最稳妥的方式是总入口 run_all.R;单独运行时从 Demo_R_Project/ 目录执行 Rscript R/04_internal_validation.R。给 Agent 的任务描述可以直接复制下面这段(方括号按你的项目替换):
让 Agent 运行完整内部验证脚本并核对产物。整体复制发送。
【背景】我的项目有一个二分类预测模型开发流程,训练/测试划分与 CV 折成员已固定在
manifest 文件中,分析参数集中在单一配置文件。训练集以外一律不许碰。
【当前任务】运行 [R/04_internal_validation.R],对每个 outer fold 在折内独立重学
插补/编码/标准化 → LASSO → 原始变量映射 → Logistic refit,合并折外预测计算
AUC(DeLong 95%CI)、Brier、校准截距/斜率与 DCA,输出三张评价图。
【约束】1. 严禁先在全训练集筛变量再做 CV;凡是要"学"的步骤全部放进折内;
2. CV 各折不是独立样本,AUC 区间只报 DeLong 法并注明口径;
3. 不得把随机 Holdout Test 称为外部验证;
4. 结果数字以实际运行输出为准,不得凭记忆填写。
【输出要求】报告产物路径:cv_predictions_logistic.csv、cv_selected_variables_by_fold.csv、
cv_metrics_logistic.csv、cv_pipeline_audit.csv、roc_cv.png、calibration_cv.png、dca_cv.png。
【验收/暂停条件】逐项报告:OOF 行数是否等于训练集样本量且每个 row_id 恰好出现一次;
各折 glm 是否收敛;AUC 与 95%CI、Brier、校准截距/斜率。命中某折结局单类、LASSO 空选、
模型不收敛/完全分离、OOF 覆盖不完整时停止并报告,不要静默换方法。
先检查输入并给出简要计划,然后继续执行指定任务;不要在计划后等待用户再次确认。
只有输入冲突、字典冲突、必须改变方法或命中暂停条件时停止。
Agent 基础与任务写法见工具手册第 3 章 把任务交给 Agent 与第 5 章 让 Agent 使用 R 与 Python。
核心实现
本章只有一条铁律:凡是要从数据里”学”的东西,全部放进折内重学。插补值、因子编码与参照水平、标准化参数、LASSO(Least Absolute Shrinkage and Selection Operator,最小绝对收缩与选择算子)的变量集合、Logistic(Logistic Regression,逻辑回归)的系数——每一项都可能”记住”评估折的信息,少重学任何一项,折外估计就不再诚实。
折内独立流水线主循环
以下是 run_fold_logistic() 的核心片段。注意评估折 ass_df 从头到尾只做两件事:被 apply_preprocessor() 用折内学好的参数变换、被折内模型预测——它不参与任何”学”的步骤:
R/04_internal_validation.R(摘录 1:折内独立重学 → LASSO → 映射 → refit → 预测)
  prep_f <- fit_preprocessor(sub_df)                     # 折内重学:插补/编码/标准化
  sub_imp <- apply_preprocessor(sub_df, prep_f)
  ass_imp <- apply_preprocessor(ass_df, prep_f)
  design_f <- build_design(sub_imp, config$predictors)
  set.seed(config$seed + f)                              # 唯一种子源的确定性偏移
  cvf <- glmnet::cv.glmnet(design_f$X, sub_imp$y, family = "binomial",
                           nfolds = config$inner_folds)
  cf <- as.matrix(stats::coef(cvf, s = config$lasso_lambda))
  terms_f <- rownames(cf)[abs(as.numeric(cf[, 1])) > .Machine$double.eps]
  terms_f <- setdiff(terms_f, "(Intercept)")
  if (length(terms_f) == 0L)
    stop("Fold ", f, ": LASSO selected no variables; aborting (no silent fallback).")
  vars_f <- map_terms_to_variables(terms_f, design_f$col_var)
  fml_f <- stats::as.formula(paste("y ~", paste(vars_f, collapse = " + ")))
  # …glm refit(含收敛/完全分离守卫,失败即中止)见完整脚本…
p <- as.numeric(stats::predict(fit_f, newdata = ass_imp, type = "response"))三个细节值得指认:set.seed(config$seed + f) 说明折内随机性来自唯一种子源的确定性偏移,不是随手撒种子;LASSO 选出的是 dummy 级 term,必须经 map_terms_to_variables() 映射回原始变量再交给 glm——分类变量任一非参照 dummy 入选即算该原始变量入选;Logistic 用入选变量重新拟合无惩罚系数,绝不直接使用 LASSO 的惩罚系数。fit_preprocessor()、build_design() 等辅助函数定义在 Demo_R_Project/R/00_setup.R,同一规则一处定义、处处复用。
折外预测的合并与断言
5 个折各产出一批评估折预测,合并为 OOF(Out-of-Fold,折外)预测主表后,脚本用一条断言守住口径:OOF 必须恰好覆盖训练集每人一次——少一个人说明某折没跑,多一个人说明有人被多个折评过,两种都是流程错误:
R/04_internal_validation.R(摘录 2:OOF 合并与覆盖断言)
fold_res <- lapply(seq_len(config$outer_folds), run_fold_logistic)

oof <- do.call(rbind, lapply(fold_res, function(r)
  data.frame(row_id = r$row_id, fold = r$fold, y = r$y, p_oof = r$p,
             stringsAsFactors = FALSE)))
oof <- oof[order(oof$row_id), ]
if (!all(sort(oof$row_id) == sort(train_ids)))
  stop("OOF predictions do not cover the training set exactly once.")
OOF 指标与 DeLong 区间
指标只在这 211 个 OOF 预测上计算,每个预测都来自一个没见过该患者的折内模型。AUC 的 95% 置信区间(Confidence Interval, CI)用 DeLong 法,方法名随指标一起落盘:
R/04_internal_validation.R(摘录 3:OOF 指标与 DeLong 区间)
roc_cv <- pROC::roc(y_oof, p_oof, quiet = TRUE)
auc_ci <- as.numeric(pROC::ci.auc(roc_cv, method = "delong"))
auc_val <- as.numeric(pROC::auc(roc_cv))
brier <- mean((p_oof - y_oof)^2)
lp <- qlogis(p_oof)
cal_intercept <- as.numeric(stats::coef(stats::glm(y_oof ~ offset(lp),
                                                   family = stats::binomial))[1])
cal_slope <- as.numeric(stats::coef(stats::glm(y_oof ~ lp,
                                               family = stats::binomial))[2])
实际运行结果
以下是 Demo 真实运行的冻结结果(R/04_internal_validation.R 自动生成):
内部验证摘要 · 本片段由 Demo 脚本自动生成,供教材引用
- 设计:5 折 outer CV;每折内独立重学插补/编码/LASSO/Logistic,严禁全训练集先筛变量。
- OOF 预测覆盖训练集 211 例(事件 75)。
- AUC = 0.844(95% CI 0.792-0.895,DeLong 法)。
- Brier = 0.1600(
mean((p-y)^2))。 - 校准:intercept = 0.011,slope = 0.847(对 OOF 预测)。
- DCA 阈值范围:0.01-0.60。
- 折间入选稳定性(折内独立重选的证据):
bmi:5/5 折入选bmi_cat:5/5 折入选glu:5/5 折入选npreg:5/5 折入选ped:5/5 折入选age:4/5 折入选bp:1/5 折入选
三张评价图
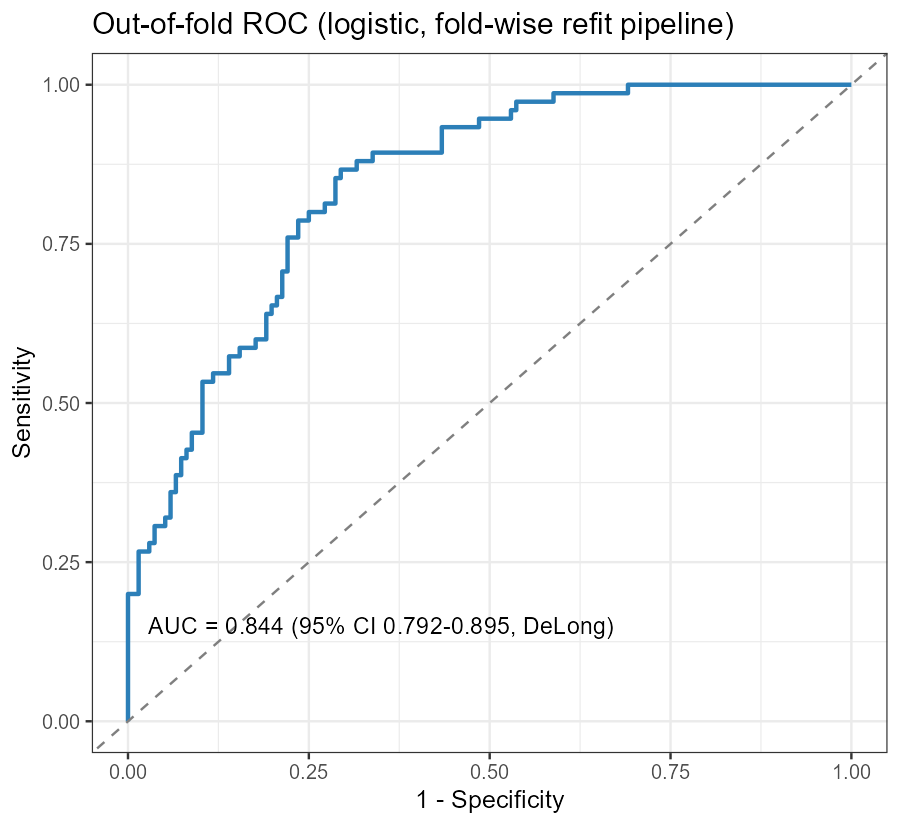
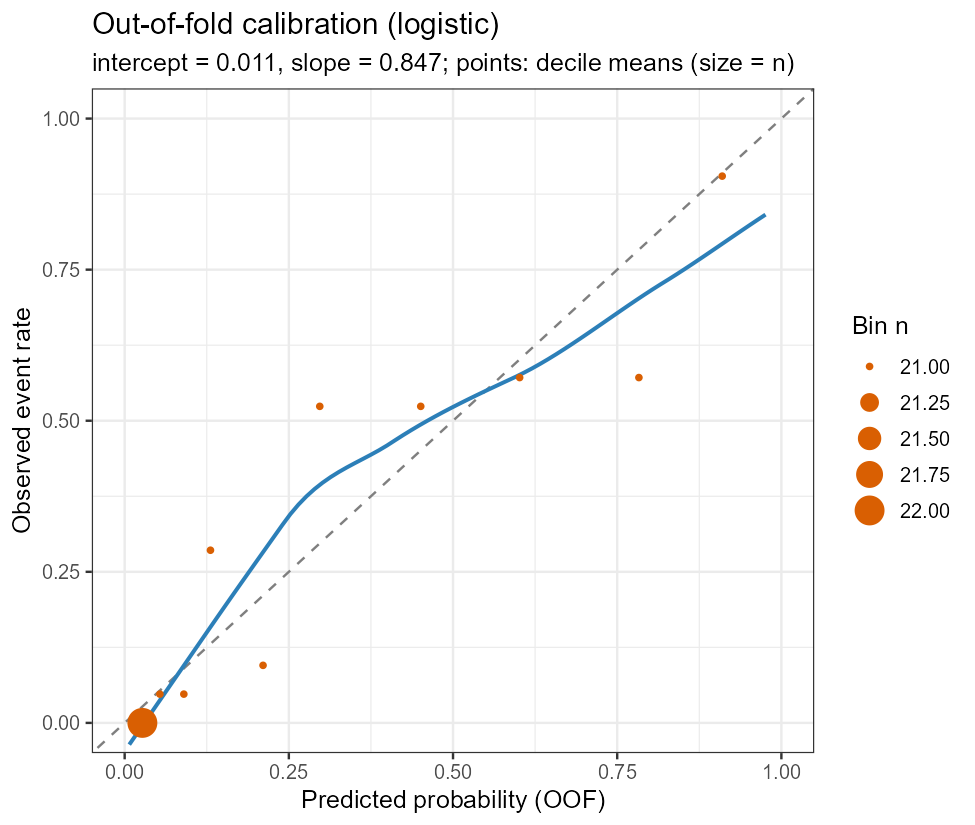
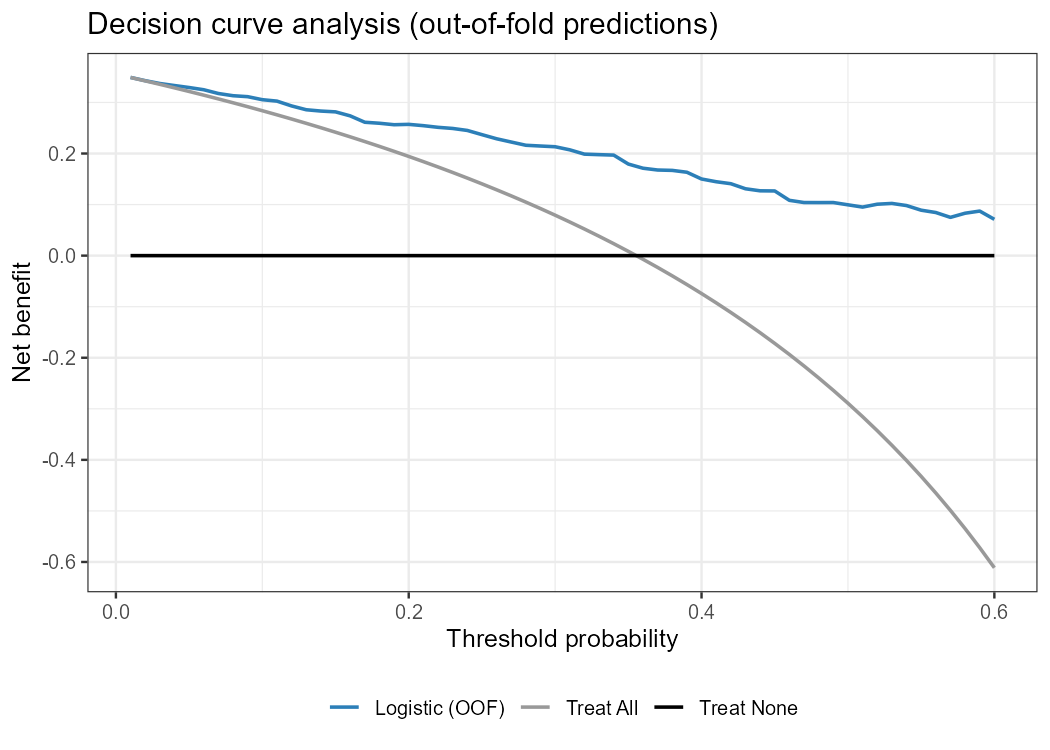
折级流水线审计表
表 4.1 由 cv_pipeline_audit.csv 整理(lambda.min 显示保留 4 位小数,完整精度见 CSV)。它是”折内真的重选了”的直接证据:如果先在全训练集固定变量再做 CV,五折的入选名单必然一模一样;而真实运行里第 4 折丢了 age、第 5 折捡回 age 并多选了 bp——筛选结果随折内训练子集而变,这正是完整流程被验证(而非被绕开)的痕迹。
bmi_cat 为技术演示派生变量(规则固定,不解释为临床阈值)。
| 折 | 折内训练 n(事件) | 评估折 n(事件) | 入选变量数 | 入选原始变量 | lambda.min |
glm 收敛 |
|---|---|---|---|---|---|---|
| 1 | 168(60) | 43(15) | 6 | npreg; glu; bmi; ped; age; bmi_cat | 0.0276 | TRUE |
| 2 | 169(60) | 42(15) | 6 | npreg; glu; bmi; ped; age; bmi_cat | 0.0214 | TRUE |
| 3 | 169(60) | 42(15) | 6 | npreg; glu; bmi; ped; age; bmi_cat | 0.0230 | TRUE |
| 4 | 169(60) | 42(15) | 5 | npreg; glu; bmi; ped; bmi_cat | 0.0260 | TRUE |
| 5 | 169(60) | 42(15) | 7 | npreg; glu; bp; bmi; ped; age; bmi_cat | 0.0183 | TRUE |
结果怎么读
AUC = 0.844(0.792–0.895,DeLong):随机抽一名事件者与一名非事件者,流程给出的折外预测把事件者排得更前的概率约 84%。注意口径:它度量的是这套流程的期望表现——211 个 OOF 预测来自 5 个不同的折内临时模型,不是最终那一个模型的成绩单。
警告CV 折不是独立样本,区间只报 DeLong 并注明局限
5 个折的训练子集互相重叠,211 个 OOF 预测并非严格独立,DeLong 区间因此偏窄,只宜作为精度的大概参照;更不要对各折分别算 AUC 再求平均±标准误——那把折当成了独立样本。任何场合报区间必须同时报方法名(DeLong)。同理,本课程所有”测试”都是随机 Holdout Test,它与训练集来自同一人群同一时期,严禁称为外部验证;外部验证必须来自另一时间/机构/人群的数据。
校准 intercept = 0.011、slope = 0.847:截距接近 0 说明平均预测概率与总体事件率基本对齐(无系统性高估/低估);斜率 0.847 < 1 说明预测概率的分散程度略过激——高预测偏高、低预测偏低,向均值收缩一点会更准,这是轻度过拟合在校准维度的样子。Brier = 0.1600 是概率预测的综合均方误差,它同时受区分度与校准影响,单看一个数意义有限,主要用于模型间横向比较(第 5 章)。
DCA:在 0.01–0.60 的阈值范围内,折外预测模型的净获益曲线在大部分临床可接受的阈值区间高于两个极端策略(全处理/全不处理),说明按模型概率做分诊决策比”一刀切”更划算。DCA 的阈值范围要按目标场景事先设定(本 Demo 在 config.R 固定为 0.01–0.60),不能看着图挑好看的区间。
折间稳定性:npreg、glu、bmi、ped、bmi_cat 五折全入选(5/5),age 4/5,bp 仅 1/5。核心变量集合稳定是流程稳健的好信号;bp 这种边缘入选提示它对该数据的贡献脆弱,第 5 章锁定变量时应有心理预期。
验收清单
运行结束逐项核对(对应实际运行结果的冻结值):
- OOF 主表行数 = 训练集样本量 211,每个
row_id恰好出现一次(脚本内置断言,失败会中止); - 5 折的
glm_converged全为TRUE,无 LASSO 空选、无单类折; cv_metrics_logistic.csv中 AUC = 0.844、95% CI 0.792–0.895、方法列写明 DeLong;Brier = 0.1600;校准 intercept = 0.011、slope = 0.847;cv_selected_variables_by_fold.csv与审计表一致:各折入选 6/6/6/5/7 个原始变量;- 三张图存在且非空,图内标注数字与 CSV 一致;
- 全程未读取 Holdout Test 成员(输入只有训练集 manifest 与 fold manifest)。
复用到自己的数据时,数字必然不同——核对的是结构与口径,不是照抄这组数。
常见错误
- 先在全训练集筛好变量再做 CV:把筛选这步”学过结局”的环节放到折外,得到的指标介于表观与诚实之间,披着”验证过”的外衣,比表观更危险。防法只有一条:凡是要学的,全部放进折内(核心实现)。
- 折内只做模型重估、复用全训练集的插补/标准化参数:同样是泄漏,只是更隐蔽。检查点:评估折是否只出现在
apply_preprocessor()与predict()里。 - 把 5 个折当独立样本:对各折 AUC 求平均±标准误,或对 OOF 套普通二项区间。折间训练集重叠,这样做区间失真;统一合并 OOF 后算一次,CI 只用 DeLong 并注明局限。
- 用表观预测画 ROC/校准图:本章三图的数据源只有
cv_predictions_logistic.csv的 OOF 列;用全训练集拟合模型对同一批人预测再画图,画出来的是表观,不是内部验证。 - 把随机 Holdout Test 称为外部验证:同一人群同一时期的随机拆分不具备外部验证的含义,论文与答辩里这是硬伤。
- 拿着 OOF 指标反复改流程重跑:OOF 被用来选优的次数多了,它自己也开始偏乐观。选模、锁变量、锁阈值是第 5 章的一次性动作,见第 5 章。
复用时替换什么
复用本章流程到自己的数据时,主循环代码不需要改,替换集中在三处:
- 配置(
config.R):outcome、positive_class、预测变量集合、outer_folds/inner_folds、lasso_lambda规则、dca_thresholds按目标场景设定; - 预处理规则(
R/00_setup.R中的fit_preprocessor()/apply_preprocessor()/build_design()):按你的数据字典调整插补、编码与标准化规则——改的是函数定义,主循环照旧调用; - 暂停条件的阈值(可选):如最小事件数、分离判定等按领域规范收紧。
不能替换的是纪律本身:折内重学、OOF 恰好覆盖一次、指标方法随结果落盘、测试集零接触。迁移到机器学习模型(RF/XGBoost/SVM)时同一套折与同一套规则继续有效,见第 5 章 机器学习比较解释与最终测试;迁移到 Python 时成员与折清单由 R 导出直接读取,见第 6 章。
相关资源
- 概念原理:讲义第 4 章 模型评价与内部验证(三顶帽子、折内重学、校准三层次);建模主线见讲义第 3 章 Logistic 候选模型
- 本书上一章:第 3 章 LASSO、Logistic 与 Nomogram;下一步:第 5 章 机器学习比较解释与最终测试
- Agent 协作:工具手册第 3 章 把任务交给 Agent、第 5 章 让 Agent 使用 R 与 Python、第 6 章 出错了怎么办
- 完整实现与产物:
Demo_R_Project/R/04_internal_validation.R、Demo_R_Project/results/;任务 Prompt:prompts/04_完整内部验证.md - 正式案例入口:
../../04_Cases/(Demo 之外的两套正式教学数据)